
BT9G LABS / เจาะลึก DHT #15
ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure
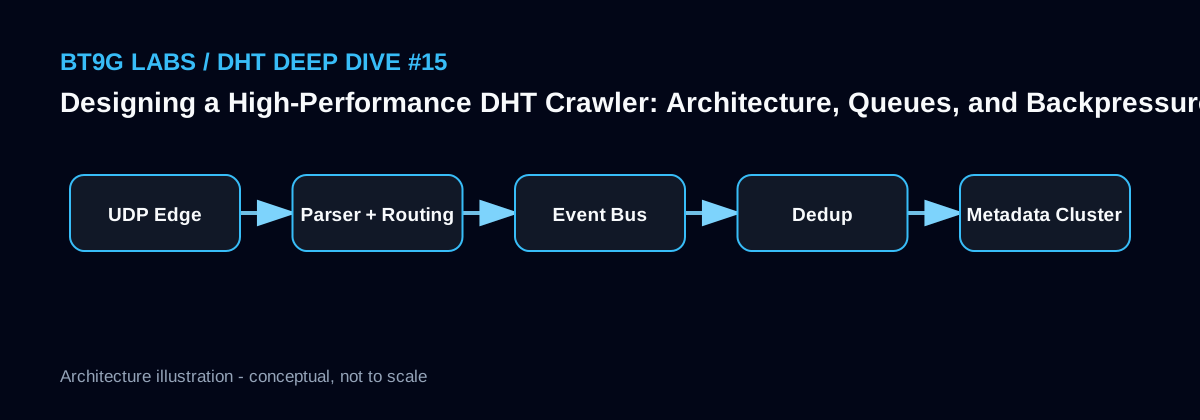
ออกแบบ crawler ที่แยก packet plane กับ work plane ใช้ bounded queue, sharding, observability และ backpressure เพื่อรักษา throughput
BT9G Labs / DHT Deep Dive #15. Crawler ที่มีประสิทธิภาพและเสถียรมาจากการแยก responsibility และควบคุม load ไม่ใช่แค่เพิ่ม goroutine หรือ socket
สรุปแบบรวดเร็ว
- หัวข้อ: ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure
- คีย์เวิร์ดหลัก: high performance DHT crawler, backpressure, queue, UDP, crawler architecture
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
แยก packet plane จาก work plane
Packet plane ควรทำ receive/send UDP, KRPC parsing, validation, transaction matching และ routing update ด้วย latency ต่ำ ส่วน work plane ทำ dedup, durable storage, metadata scheduling, enrichment และ indexing ที่หนักกว่า
หากรวมทั้งหมด database query ที่ช้าสามารถ block UDP receive และทำให้ packet loss สูงขึ้น Queue หรือ channel ระหว่าง stage ช่วยแยก backpressure ได้
ทุกอย่างต้อง bounded
จำนวน inflight query, queue size, retry buffer, open connection, goroutine และ cache ต้องมี limit หากไร้ limit ระบบจะดูเร็วในช่วงปกติ แต่พอ downstream ช้าก็ใช้ memory/file descriptor พุ่งจนล้ม
เมื่อ queue เต็ม Scheduler ควรลด concurrency, เลื่อนงาน low priority หรือ sampling event ที่ duplicate ง่าย
Shard ตาม responsibility
การ scale-out ไม่จำเป็นต้องให้ทุก instance ทำทุกงาน UDP collector, hash ledger, metadata fetcher, validator และ index writer ใช้ resource คนละแบบ การแยกช่วยให้เพิ่ม capacity ตรง bottleneck
Hash-based partitioning หรือ job lease ช่วยลดงานซ้ำของ InfoHash เดียวกัน
วัดก่อน optimize
ควรดู packet rate, parse error, routing latency, queue depth, dedup hit, Peer connect success, metadata success, verification failure, CPU, memory และ socket error Throughput สุดท้ายถูกจำกัดโดย stage ที่อ่อนที่สุด
Benchmark packet/sec ในเครื่องอาจหลอกตา หาก verified metadata/sec ใน Internet ยังต่ำ
ตัวอย่างการนำไปใช้
[UDP sockets]
     |
     v
[KRPC + routing] ---> metrics
     |
     v
[bounded hash-event queue]
     |
     v
[dedup / scheduler] ---> [retry store]
     |
     v
[metadata workers] ---> [validation] ---> [DB / Search]
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- เพิ่ม concurrency แบบไร้ขีดจำกัด
- ทำ database I/O หนักใน UDP loop
- รวมทุกหน้าที่ไว้ใน monolith ที่ขาด observability
- optimize packet rate แต่ไม่วัด verified metadata throughput
บทความ BT9G Labs ที่เกี่ยวข้อง
- Seeder และ Leecher: ตัวเลขหมายถึงอะไรและวัดอย่างไร
- ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า
- ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที
- วิธี Deduplicate Observation ของ InfoHash หลายพันล้านรายการโดยไม่เสียงาน Metadata
เอกสารอ้างอิง
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
บทความถัดไป: ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่