
BT9G LABS / เจาะลึก DHT #13
Seeder และ Leecher: ตัวเลขหมายถึงอะไรและวัดอย่างไร
ทำความเข้าใจนิยาม Seeder/Leecher วิธีที่ Tracker scrape นับ complete/incomplete และเหตุใด DHT จึงให้ตัวเลข global แบบแม่นยำไม่ได้
BT9G Labs / DHT Deep Dive #13. ตัวเลข Seeder และ Leecher ดูเรียบง่าย แต่ความหมายขึ้นกับแหล่งข้อมูลและเวลาที่สังเกตอย่างมาก
สรุปแบบรวดเร็ว
- หัวข้อ: Seeder และ Leecher: ตัวเลขหมายถึงอะไรและวัดอย่างไร
- คีย์เวิร์ดหลัก: Seeder, Leecher, Tracker scrape, DHT, Torrent statistics
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
เริ่มจากนิยาม
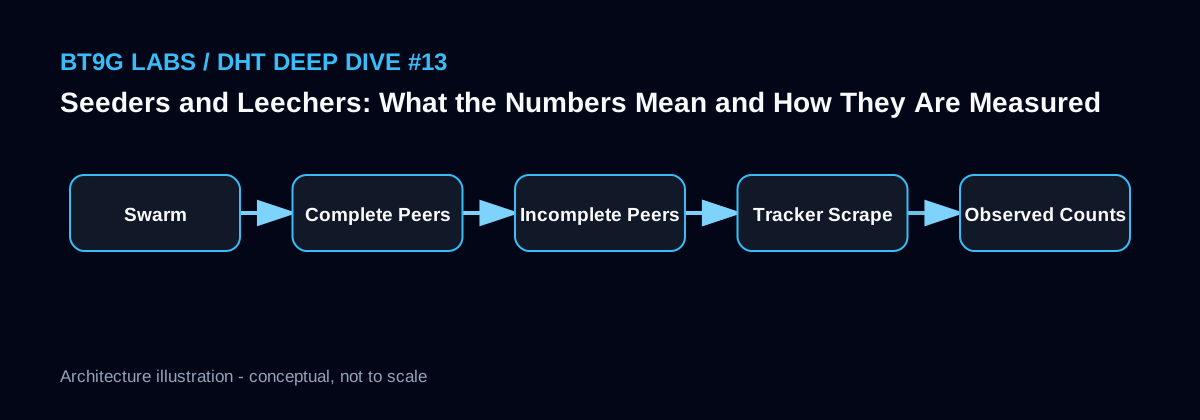
Seeder โดยทั่วไปคือ Peer ที่มี content ครบและยังแบ่งปันอยู่ ส่วน Leecher คือ Peer ที่ยังมีไม่ครบ แต่ในโลกจริง Peer อาจหยุด client, เปลี่ยน network หรือรายงานสถานะไม่สมบูรณ์
ดังนั้นตัวเลขบนเว็บไซต์เป็น snapshot หรือ estimate จากวิธีวัดหนึ่ง ไม่ใช่ข้อเท็จจริงถาวรของทั้ง Internet
Counter จาก Tracker scrape
Tracker ที่รองรับ scrape สามารถตอบ complete, incomplete และบางครั้ง downloaded ต่อ InfoHash ได้ นี่เป็นแหล่งตรงที่สุดสำหรับ label Seeder/Leecher แต่ครอบคลุมเฉพาะ population ที่ Tracker นั้นมองเห็น
หาก Torrent ใช้หลาย Tracker ไม่ควรนำตัวเลขมาบวกตรง ๆ เพราะ Peer เดียวอาจอยู่ในหลาย Tracker
ทำไม DHT ไม่ให้ exact seeder count
BEP 5 get_peers ส่ง Peer endpoint หรือ node ที่ใกล้ target มากกว่า ไม่มี field global ที่บอกจำนวน complete/incomplete Peer ทั้ง Swarm Crawler เองก็เห็นเพียง subset ของ network
การ classify Seeder จาก DHT ต้องมี connection และ state เพิ่ม และยังไม่รับประกัน coverage ครบ
Product semantics ที่ตรงความจริงกว่า
ถ้าข้อมูลมาจาก Tracker ควรแสดง source กับ timestamp หากมีเพียง DHT activity ควรใช้ label เช่น 'recent peers observed' หรือ 'recent activity' แทน 'global seeders'
ความโปร่งใสของ source ช่วยให้ผู้ใช้เข้าใจว่าตัวเลขเป็น operational signal ไม่ใช่การสำรวจทั้ง Internet
ตัวอย่างการนำไปใช้
{
  "source": "tracker_scrape",
  "infohash": "...",
  "complete": 142,
  "incomplete": 37,
  "observed_at": "2026-09-16T03:00:00Z"
}
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- แสดง Seeder/Leecher โดยไม่ระบุ source หรือ timestamp
- บวกตัวเลขหลาย Tracker โดยไม่ dedup
- คิดว่า DHT ให้ exact seeder count
- ใช้ activity count แทนจำนวน Seeder
บทความ BT9G Labs ที่เกี่ยวข้อง
- BEP 10 Extension Protocol: BitTorrent Negotiate ฟีเจอร์ใหม่โดยไม่ทำลาย Compatibility
- Tracker vs DHT vs PEX: เปรียบเทียบสามกลไก Peer Discovery ของ BitTorrent
- ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า
- ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure
เอกสารอ้างอิง
บทความถัดไป: ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่