
BT9G LABS / เจาะลึก DHT #14
ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า
เรียนรู้สาเหตุ metadata fetch ล้มเหลวตั้งแต่ Peer stale, ut_metadata ไปจนถึง hash mismatch และออกแบบ retry ตามประเภท failure
BT9G Labs / DHT Deep Dive #14. ใน crawler ระดับ Internet ความล้มเหลวของ metadata เป็นเรื่องปกติ สิ่งสำคัญคือ classify failure และ retry อย่างฉลาด
สรุปแบบรวดเร็ว
- หัวข้อ: ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า
- คีย์เวิร์ดหลัก: metadata fetch failure, ut_metadata, retry scheduler, Peer timeout, Torrent metadata
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
Failure เป็นเรื่องปกติเมื่อทำงานระดับ Internet
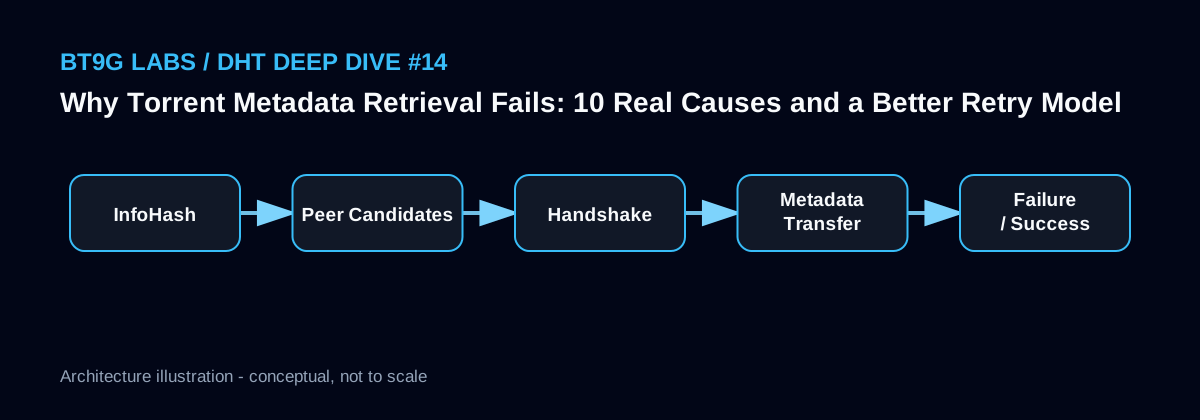
Metadata pipeline ผ่านหลาย stage: หา endpoint, connect, BitTorrent handshake, extension negotiation, ut_metadata, piece transfer, parsing และ hash verification ทุก stage สามารถ fail แยกกันได้
Metric metadata_failed ตัวเดียวจึงไม่พอ ควรเก็บ stage, error class, Peer source, latency และ attempt count เพื่อรู้ว่า bottleneck จริงอยู่ตรงไหน
สิบสาเหตุที่พบบ่อย
สาเหตุทั่วไปได้แก่ endpoint stale, connect timeout, connection refused, Peer ออกจาก Swarm แล้ว, handshake fail, ไม่รองรับ extension protocol, ไม่มี ut_metadata, metadata_size ผิดปกติ, piece timeout/reject และ metadata ครบแต่ hash mismatch นอกจากนี้ NAT และ local resource limit ยังมักถูกเข้าใจผิดว่าเป็นปัญหาจาก remote
แต่ละ failure class มีโอกาส recovery ต่างกัน
แยก transient ออกจาก permanent-looking
Timeout, no route หรือไม่มี Peer ตอนนี้ มักเหมาะกับ exponential backoff ส่วน hash mismatch ซ้ำจากหลาย source อาจใช้ backoff ยาวขึ้น แต่ไม่ควรตัดสินว่า 'permanent' จริง ๆ ง่ายเกินไปในเครือข่าย P2P ที่เปลี่ยนตลอดเวลา
เก็บ next_retry_at, failure_class, attempts และ last_success_signal เพื่อให้ scheduler เลือกงานได้ดี
Reactivation signal
Observation ใหม่จาก DHT, Peer ใหม่, Tracker ที่กลับมา active หรือ activity spike สามารถเป็นเหตุผลให้ retry เร็วขึ้น แม้ hash เดิมจะอยู่ใน backoff ระยะยาว
การผสม time-based backoff กับ evidence ช่วยลดงานที่เสียเปล่าแต่ยังตอบสนองเร็วเมื่อโอกาสสำเร็จเพิ่มขึ้น
ตัวอย่างการนำไปใช้
NEW -> peer discovery
  no peers -> retry in 30m, 2h, 8h, 1d, 7d...
  peers found -> handshake
      no BEP10/9 -> try another peer
      transfer timeout -> peer penalty + retry
      valid metadata -> COMPLETE

fresh observation -> reduce backoff and re-queue
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- รวม error ทุกชนิดเป็นสถานะ fail เดียว
- ลบ InfoHash หลังล้มเหลวไม่กี่ครั้ง
- retry ด้วย interval คงที่โดยไม่มี backoff
- ไม่ใช้ fresh activity เพื่อ re-activate hash
บทความ BT9G Labs ที่เกี่ยวข้อง
- Tracker vs DHT vs PEX: เปรียบเทียบสามกลไก Peer Discovery ของ BitTorrent
- Seeder และ Leecher: ตัวเลขหมายถึงอะไรและวัดอย่างไร
- ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure
- ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที
เอกสารอ้างอิง
บทความถัดไป: ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่