
BT9G LABS / เจาะลึก DHT #16
ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที
โมเดล capacity สำหรับ 1,000+ verified metadata ต่อนาที ทั้ง concurrency, latency, success rate, Peer discovery และ host limits
BT9G Labs / DHT Deep Dive #16. ควรวัด throughput จาก metadata ที่ verify สำเร็จต่อนาที ไม่ใช่จำนวน request ที่ส่งออกไป
สรุปแบบรวดเร็ว
- หัวข้อ: ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที
- คีย์เวิร์ดหลัก: 1000 metadata per minute, Torrent metadata throughput, concurrency, Little's Law, DHT architecture
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
เริ่มจาก success throughput
1,000 metadata ต่อนาทีเท่ากับประมาณ 16.7 verified metadata ต่อวินาที หาก attempt สำเร็จเพียง 20% ระบบอาจต้องทำมากกว่า 80 attempt ต่อวินาทีก่อนคิด retry และ timeout ดังนั้น request rate ไม่เท่ากับ output ที่มีประโยชน์
ควรนิยาม success เป็น metadata ครบ, hash verification ผ่าน และบันทึกสำเร็จ
Little's Law ให้ค่าประมาณเริ่มต้น
หากหนึ่ง attempt ครอง slot หลายวินาที concurrency ที่ต้องใช้โดยคร่าวคือ arrival rate คูณเวลาที่อยู่ในระบบ เช่น 80 attempt/s และค่าเฉลี่ย 4 วินาทีอาจต้องมี slot พร้อมกันหลายร้อย
Tail latency และ timeout ยาวสามารถกิน slot จึงควรมี deadline และ alternate Peer scheduling
Peer discovery อาจเป็น bottleneck ที่ซ่อนอยู่
Metadata worker ทำงานไม่ได้ถ้าไม่มี Peer endpoint ที่ดี DHT lookup, Tracker, PEX และ candidate cache ต้องป้อน Peer ที่สดพอ
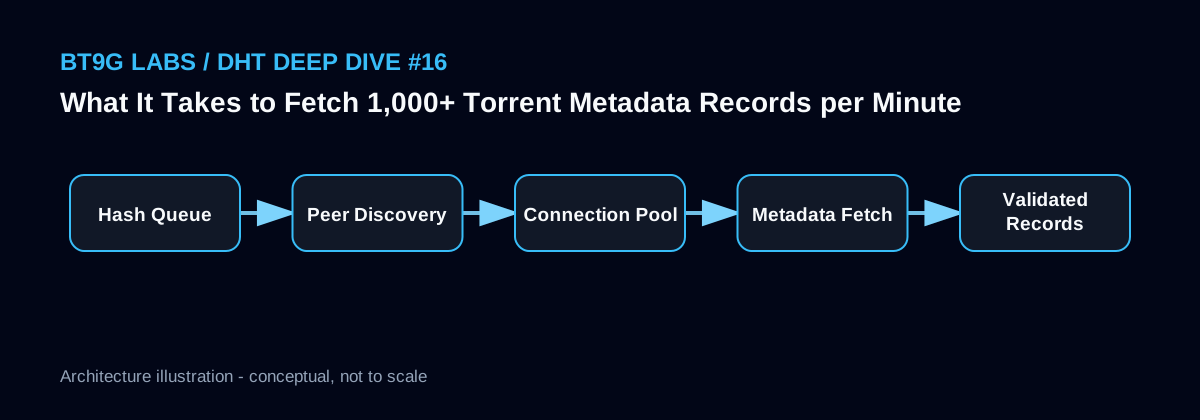
ควรวัด funnel แยกเป็น hashes ready, peers discovered, connect success, ut_metadata supported และ metadata verified
Host limits ยังสำคัญ
File descriptor, ephemeral port, NAT table, kernel buffer, TCP backlog, bandwidth และ memory สามารถจำกัดเครื่องเดียวได้ Kernel tuning ช่วยได้ แต่เมื่อเครื่องเข้าสู่ diminishing return ควร scale-out
ใช้ fetcher หลายตัวกับ shared queue และ idempotency เพื่อเพิ่ม capacity อย่างปลอดภัย
ตัวอย่างการนำไปใช้
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- วัด request rate เป็น metadata throughput
- สมมติว่า success rate เท่ากับ 100%
- ละเลย Peer discovery ใน capacity planning
- เพิ่ม concurrency ก่อนตรวจ file descriptor, port และ timeout
บทความ BT9G Labs ที่เกี่ยวข้อง
- ทำไมการดึง Torrent Metadata จึงล้มเหลว: 10 สาเหตุจริงและโมเดล Retry ที่ดีกว่า
- ออกแบบ DHT Crawler ประสิทธิภาพสูง: Architecture, Queue และ Backpressure
- วิธี Deduplicate Observation ของ InfoHash หลายพันล้านรายการโดยไม่เสียงาน Metadata
- ทำไม InfoHash ที่ล้มเหลวยังควรถูกเก็บไว้: ออกแบบ Retry Scheduler ระยะยาว
เอกสารอ้างอิง
บทความถัดไป: วิธี Deduplicate Observation ของ InfoHash หลายพันล้านรายการโดยไม่เสียงาน Metadata →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่