BT9G LABS / เจาะลึก DHT #19
สร้าง BitTorrent Search Index: จาก DHT สู่ Metadata และ Elasticsearch
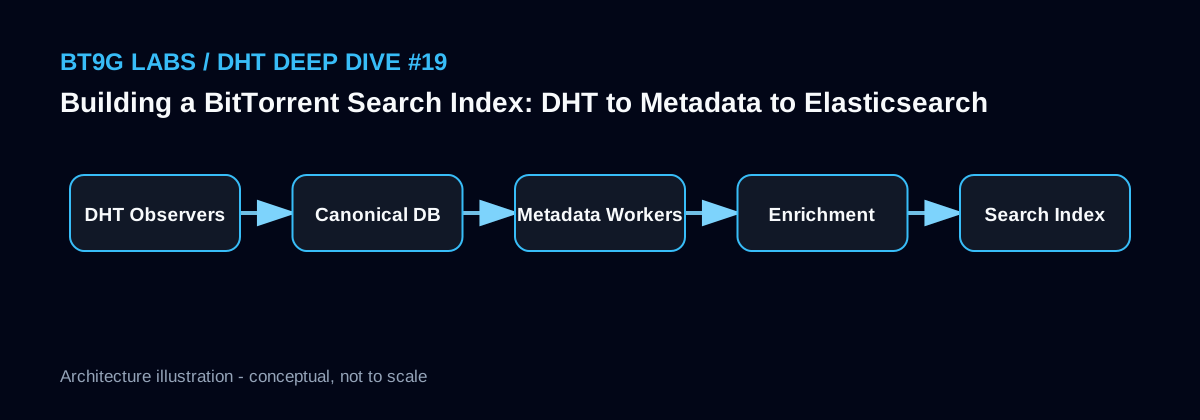
ออกแบบ pipeline ที่แยก discovery, metadata validation, canonical storage, enrichment และ Elasticsearch เพื่อให้ index ปลอดภัยและ rebuild ได้
BT9G Labs / DHT Deep Dive #19. Search index ควรเป็นข้อมูลที่สร้างจาก metadata ที่ตรวจสอบแล้ว ไม่ใช่จุดแรกที่รับข้อมูลดิบจาก DHT
สรุปแบบรวดเร็ว
- หัวข้อ: สร้าง BitTorrent Search Index: จาก DHT สู่ Metadata และ Elasticsearch
- คีย์เวิร์ดหลัก: BitTorrent search engine, DHT, metadata pipeline, Elasticsearch, search indexing
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
Search index ควรอยู่หลัง validation
Discovery event และ metadata จาก Peer ยังไม่ควรเข้า Elasticsearch โดยตรง Pipeline ควรทำ identity dedup, metadata acquisition, hash verification, parsing และ canonical persistence ก่อน แล้วค่อยสร้าง search document จาก record ที่ valid
ด้วยขอบเขตนี้ index สามารถลบและ rebuild ได้โดยไม่สูญเสีย source of truth
Canonical storage และ derived search storage
Canonical database เก็บ identity, verified metadata, file list, size, hash version และ lifecycle state ส่วน Elasticsearch เก็บ representation ที่ optimize สำหรับ full-text, filter, aggregation, autocomplete และ ranking
ไม่ควรใช้ Elasticsearch เป็นที่เดียวที่เก็บ raw metadata เพราะ mapping สามารถเปลี่ยนได้
Enrichment โดยไม่ทำลาย identity
Language detection, tokenization, category, tag, normalized title และ media hint สามารถเพิ่มเป็น enrichment และคำนวณใหม่ได้เมื่อ rule หรือ model เปลี่ยน
อย่าแก้ bytes ที่ใช้ verify InfoHash Protocol identity ต้อง immutable
Ranking signal
Ranking สามารถรวม text relevance, metadata freshness, last_seen, recent activity, file completeness, source diversity และ document quality โดยแต่ละ signal ควรถูก normalize เพื่อไม่ให้ event volume จาก crawler ตัวเดียวครอบงำผล
การแยก feature ออกจาก canonical data ทำให้ทดลองสูตร ranking ได้ง่าย
ตัวอย่างการนำไปใช้
{
  "infohash": "...",
  "title": "Example Release",
  "total_size": 734003200,
  "file_count": 12,
  "extensions": ["mkv", "srt"],
  "first_seen": "...",
  "last_seen": "...",
  "metadata_verified": true,
  "activity_score": 0.73
}
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- index metadata ก่อน hash verification
- ใช้ Elasticsearch เป็น source of truth เพียงตัวเดียว
- เปลี่ยน identity data ระหว่าง enrichment
- ปล่อยให้ activity metric ดิบตัวเดียวครอง ranking
บทความ BT9G Labs ที่เกี่ยวข้อง
- วิธี Deduplicate Observation ของ InfoHash หลายพันล้านรายการโดยไม่เสียงาน Metadata
- ทำไม InfoHash ที่ล้มเหลวยังควรถูกเก็บไว้: ออกแบบ Retry Scheduler ระยะยาว
- BT9G จะ Index BitTorrent Metadata ในสเกลใหญ่ได้อย่างไร: สถาปัตยกรรม DHT อ้างอิง
เอกสารอ้างอิง
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 48 - Tracker Protocol Extension: Scrape
บทความถัดไป: BT9G จะ Index BitTorrent Metadata ในสเกลใหญ่ได้อย่างไร: สถาปัตยกรรม DHT อ้างอิง →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่