
BT9G LABS / เจาะลึก DHT #18
ทำไม InfoHash ที่ล้มเหลวยังควรถูกเก็บไว้: ออกแบบ Retry Scheduler ระยะยาว
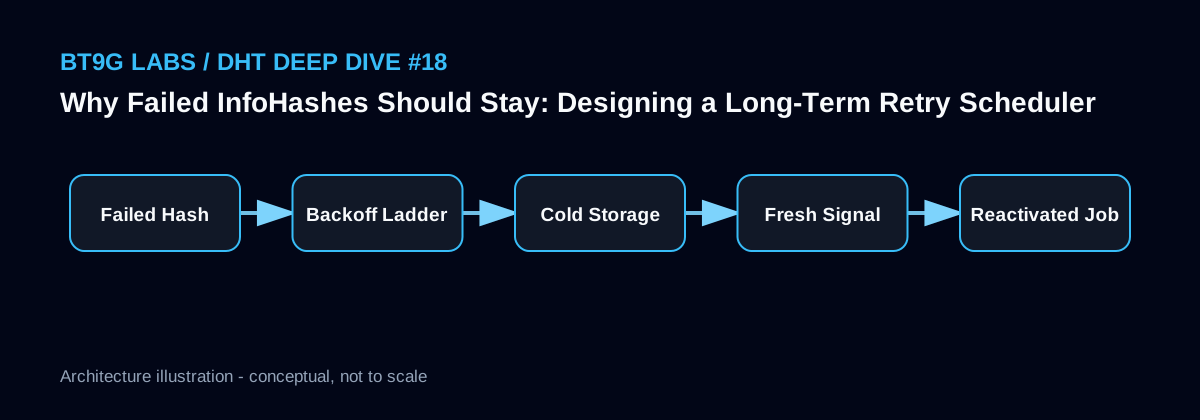
ออกแบบ retry scheduler ที่เก็บ hash ล้มเหลว ใช้ backoff ตาม failure class รองรับ reactivation signal และมี queue แบบ durable
BT9G Labs / DHT Deep Dive #18. Swarm แบบ P2P เปลี่ยนตลอดเวลา ความล้มเหลววันนี้ไม่ได้พิสูจน์ว่า metadata จะไม่มีวันหาได้อีก
สรุปแบบรวดเร็ว
- หัวข้อ: ทำไม InfoHash ที่ล้มเหลวยังควรถูกเก็บไว้: ออกแบบ Retry Scheduler ระยะยาว
- คีย์เวิร์ดหลัก: InfoHash retry, retry scheduler, exponential backoff, reactivation signal, DHT metadata
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
Failure timestamp ไม่ใช่ tombstone
Peer อาจ offline ตอน crawler ลอง แต่กลับมาในอีกไม่กี่วัน Tracker อาจฟื้น DHT อาจพบ endpoint ใหม่ หรือ user ใหม่อาจทำ Swarm เก่ากลับมา active การลบ InfoHash หลัง fail จึงทิ้งโอกาสเหล่านี้ไป
ควรเก็บ identity และ attempt history แบบกะทัดรัด โดยใช้สถานะอย่าง dormant หรือ retry later แทน dead forever
Backoff ควรขึ้นกับชนิดของ failure
Connect timeout, no peers, extension unsupported, reject และ hash mismatch มีพฤติกรรมต่างกัน No peers อาจ retry หลังช่วงหนึ่ง ส่วน mismatch ซ้ำจากหลาย source อาจใช้ backoff นานกว่า
เพิ่ม jitter เพื่อไม่ให้ job หลายล้านตัวตื่นพร้อมกัน และจำกัด retry budget เพื่อให้งานใหม่ยังได้ capacity
Fresh activity ควรชนะความล้มเหลวเก่า
หาก hash ที่ dormant กลับมาปรากฏบ่อยใน DHT หรือ source ใหม่ให้ Peer fresh Scheduler ควรเพิ่ม priority และเลื่อน next_retry_at ให้เร็วขึ้น นี่คือ event-driven reactivation
Backoff ลดงานเสียเปล่าเมื่อไม่มีสัญญาณ แต่ fresh signal ทำให้ตอบสนองเร็วเมื่อโอกาสสำเร็จสูงขึ้น
Retry queue ต้อง durable
ไม่ควรเก็บ schedule ไว้ใน memory อย่างเดียว Restart ต้องไม่ทำให้ state หลายล้านรายการหาย หรือรันทุก job ใหม่ตั้งแต่ต้น ใช้ database, durable queue หรือ time-indexed structure ที่ reconstruct ได้
Worker ควรใช้ lease และ idempotency เพื่อไม่ให้หลาย instance ทำ hash เดียวกันโดยไม่จำเป็น
ตัวอย่างการนำไปใช้
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- ลบ hash หลัง failure ครั้งเดียว
- ใช้ backoff แบบเดียวกับ error ทุกประเภท
- ไม่ใส่ jitter ใน retry schedule ขนาดใหญ่
- เก็บ retry state เฉพาะใน process memory
บทความ BT9G Labs ที่เกี่ยวข้อง
- ต้องใช้อะไรบ้างเพื่อดึง Torrent Metadata มากกว่า 1,000 รายการต่อนาที
- วิธี Deduplicate Observation ของ InfoHash หลายพันล้านรายการโดยไม่เสียงาน Metadata
- สร้าง BitTorrent Search Index: จาก DHT สู่ Metadata และ Elasticsearch
- BT9G จะ Index BitTorrent Metadata ในสเกลใหญ่ได้อย่างไร: สถาปัตยกรรม DHT อ้างอิง
เอกสารอ้างอิง
บทความถัดไป: สร้าง BitTorrent Search Index: จาก DHT สู่ Metadata และ Elasticsearch →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่