
BT9G LABS / DHT Deep Dive #18
Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler
Как сохранять исторические хеши, охлаждать неактивные Swarm и быстро реактивировать задачу при новой активности.
BT9G Labs / DHT Deep Dive #18. Ошибка сегодня не должна быть вечным tombstone: надежнее хранить дешёвое состояние и регулировать частоту сетевых попыток.
Краткое резюме
- Тема: Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler
- Ключевые слова: InfoHash retry, exponential backoff, cold swarm, scheduler, Metadata retry
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
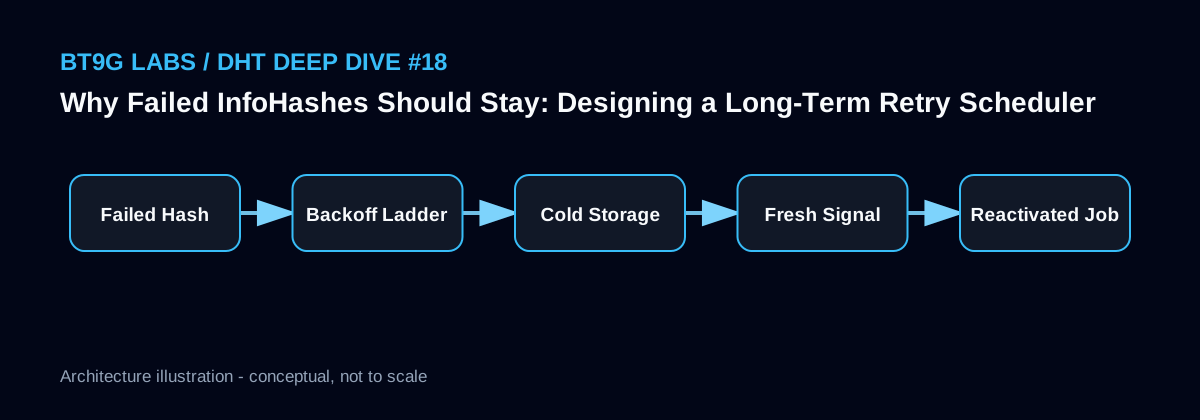
Системная схема
Failure timestamp — не tombstone
Сегодня Metadata может быть недоступна, а через неделю появится новый Peer. Удаление InfoHash уничтожает исторический контекст. Гораздо дешевле хранить компактную запись и постепенно увеличивать интервал повторов, чем постоянно делать дорогие соединения.
Так исторический ledger становится долгосрочным активом.
Backoff по типу ошибки
DHT timeout, connection refused, unsupported ut_metadata и hash mismatch означают разные вещи. Временный сетевой сбой стоит повторить быстрее; многомесячное отсутствие Peer — отложить надолго. Exponential backoff полезен, но должен иметь максимум и возможность внешнего пробуждения.
Retry policy лучше строить от error class и recent activity.
Новая активность будит старые задачи
Свежий announce, новый Peer candidate или Tracker signal должны переопределять старое пессимистичное решение и переносить next attempt ближе. Retry queue должна быть durable: хранить next_attempt_at в БД/очереди с lease-механизмом, а не только в RAM процесса.
Это переживает рестарты и не теряет миллионы отложенных работ.
Эскиз реализации
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Удалять hash после первого failure.
- Использовать одинаковый retry interval для всех error classes.
- Не реагировать на свежую активность.
- Хранить долгосрочный retry heap только в памяти процесса.
Связанные статьи BT9G Labs
- Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту
- Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
- Как построить BitTorrent search index: DHT → Metadata → Elasticsearch
- Как BT9G может масштабировать индексацию BitTorrent Metadata: эталонная DHT-архитектура
Источники
Следующая статья: Как построить BitTorrent search index: DHT → Metadata → Elasticsearch →
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.