
BT9G LABS / DHT Deep Dive #17
Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
Многоуровневый dedup с exact keys, Bloom filter, hot cache и durable state для DHT ingestion большого масштаба.
BT9G Labs / DHT Deep Dive #17. Deduplication — отдельная подсистема, определяющая экономику crawler задолго до миллиардного масштаба.
Краткое резюме
- Тема: Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
- Ключевые слова: InfoHash deduplication, Bloom filter, Redis, large-scale DHT, Metadata scheduler
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
Системная схема
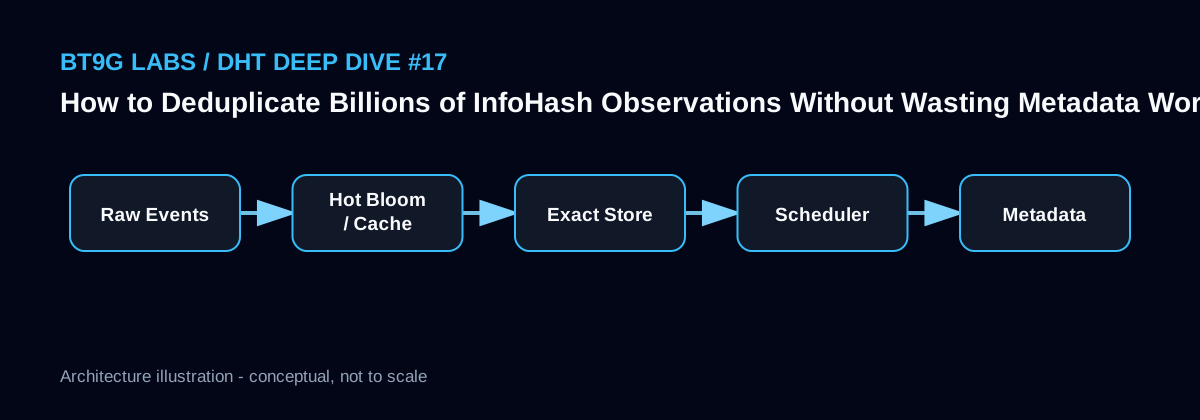
Многоуровневый dedup
Популярный InfoHash появляется снова и снова. Если каждый event идет в primary database и создает Metadata job, система платит за одну и ту же работу многократно. Практичная схема: process-local recent set → Bloom filter → hot cache → durable exact store.
Каждый слой отсекает все более дорогие повторы, а source of truth остается точным.
Bloom filter — фильтр, не истина
Bloom filter очень компактен и не дает false negative, но допускает false positive. Поэтому он хорош для решения «скорее всего уже видели» и сокращения DB lookups, однако не должен навсегда блокировать новый объект без проверки exact store.
Это особенно важно, когда цена пропуска уникального InfoHash выше дополнительного чтения из БД.
Existence отдельно от scheduling state
Факт «хеш уже известен» не означает «с ним больше ничего не нужно делать». Metadata могла никогда не быть получена, могла устареть derived classification, а новая активность способна повысить priority. Durable record должен хранить first_seen, last_seen, metadata_state, retry_state и activity отдельно.
Для миллиардов ключей заранее продумывают partitioning, индексный размер и exact lookup по primary key.
Эскиз реализации
CREATE TABLE infohash_state (
  hash VARBINARY(32) NOT NULL,
  hash_type TINYINT NOT NULL,
  first_seen DATETIME NOT NULL,
  last_seen DATETIME NOT NULL,
  seen_count BIGINT NOT NULL,
  metadata_status TINYINT NOT NULL,
  next_retry DATETIME NULL,
  PRIMARY KEY(hash_type, hash)
);
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Делать primary DB lookup на каждый raw event.
- Использовать Bloom filter как абсолютный source of truth.
- Хранить только
seen=trueбез состояния Metadata и retry. - Откладывать решение partitioning до миллиардного масштаба.
Связанные статьи BT9G Labs
- Архитектура высокопроизводительного DHT crawler: очереди, backpressure и границы ресурсов
- Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту
- Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler
- Как построить BitTorrent search index: DHT → Metadata → Elasticsearch
Источники
Следующая статья: Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler →
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.