
BT9G LABS / DHT Deep Dive #15
Архитектура высокопроизводительного DHT crawler: очереди, backpressure и границы ресурсов
Высокий throughput DHT observation с эффективным UDP, bounded memory и отдельным контуром Metadata workers.
BT9G Labs / DHT Deep Dive #15. Производительность достигается разделением ответственности и управляемой нагрузкой, а не бесконечным количеством goroutine.
Краткое резюме
- Тема: Архитектура высокопроизводительного DHT crawler: очереди, backpressure и границы ресурсов
- Ключевые слова: DHT crawler architecture, backpressure, UDP, queues, high throughput
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
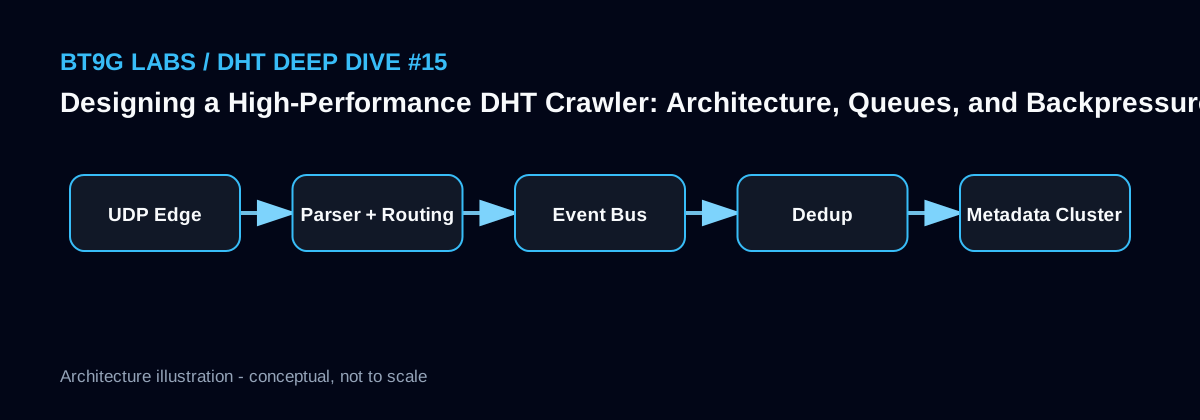
Системная схема
Packet plane отдельно от work plane
UDP reader должен делать минимум: валидация KRPC, маршрутизация transaction ID, обновление небольшого состояния и отправка события в bounded queue. Database writes, Metadata connection и indexing должны выполняться отдельными workers.
Так медленный downstream не блокирует сетевой hot path и каждый этап можно масштабировать независимо.
Ограничивать нужно все
Unlimited queue, goroutine и retry — это отложенный OOM. Нужны лимиты на outstanding RPC, discovery queue, Metadata jobs, connections per host и retry heap. При перегрузке система должна замедлить активный crawling, объединить дубликаты или отбросить низкоценные повторные observations.
Backpressure — часть нормальной архитектуры, а не аварийный режим.
Метрики до оптимизации
Полезные показатели: packet rate, query success, unique hash rate, Peer connect success, BEP 10 support, Metadata success, completion latency и queue wait. Только после этого можно понять, что реально ограничивает throughput: socket handling, network region, timeout, Peer quality, storage или search indexing.
Масштабирование без ownership-модели часто просто умножает дубликаты работы.
Эскиз реализации
[UDP sockets]
     |
     v
[KRPC + routing] ---> metrics
     |
     v
[bounded hash-event queue]
     |
     v
[dedup / scheduler] ---> [retry store]
     |
     v
[metadata workers] ---> [validation] ---> [DB / Search]
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Использовать unlimited goroutine как стратегию масштабирования.
- Выполнять медленные операции в UDP hot path.
- Клонировать один сервис без ownership и dedup.
- Тюнить систему без поэтапных метрик.
Связанные статьи BT9G Labs
- Seeders и Leechers: что означают цифры и как их измеряют
- Почему получение Torrent Metadata не удается: 10 реальных причин и правильная модель retry
- Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту
- Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
Источники
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
Следующая статья: Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту →
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.