
BT9G LABS / DHT Deep Dive #16
Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту
Capacity planning Metadata pipeline по success throughput, Peer discovery, connection rate, timeout budget и concurrency.
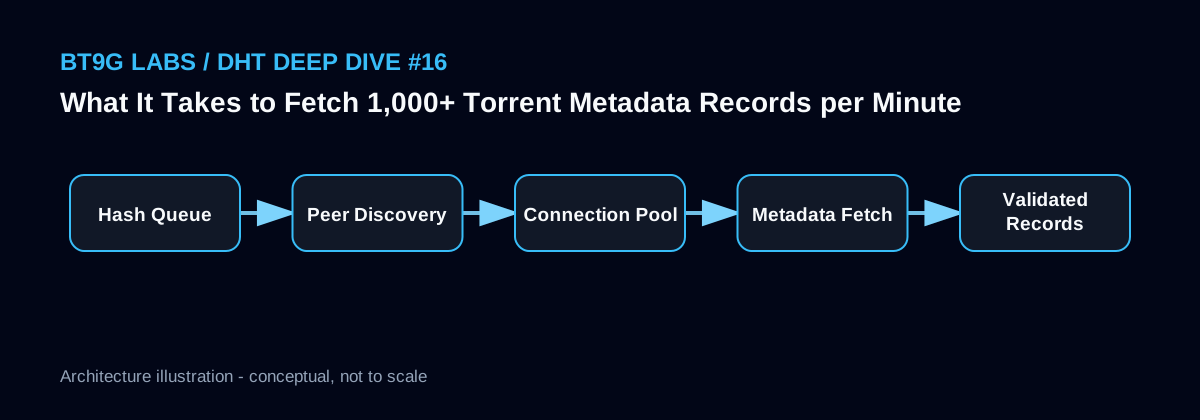
BT9G Labs / DHT Deep Dive #16. Считаем требуемый параллелизм от успешных результатов, а не от количества отправленных запросов.
Краткое резюме
- Тема: Что нужно, чтобы получать 1 000+ Torrent Metadata в минуту
- Ключевые слова: 1000 metadata/min, Metadata pipeline, concurrency, Little's Law, BitTorrent crawler
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
Системная схема
Начинайте с success throughput
1 000 успешных Metadata в минуту — примерно 16,7 результата/с. Если только 20% попыток доходят до валидированного Metadata, системе потребуется порядка 80+ качественных attempts/s. Discovery rate InfoHash сам по себе ничего не гарантирует.
Нужно измерять conversion между стадиями: hash → Peer candidates → connected → extension supported → metadata validated.
Little's Law как первая оценка
Если средняя попытка занимает 5 секунд при 80 attempts/s, в работе будет около 400 задач. Длинный хвост timeout увеличит реальную потребность в concurrency. При этом слишком большой параллелизм упрется в file descriptors, conntrack/NAT, bandwidth, CPU или лимиты удаленных Peer.
Поэтому расчет — стартовая точка, а не гарантия производительности.
Peer quality и границы хоста
Metadata workers не помогут, если upstream дает мало достижимых Peer. Приоритизация свежих, ранее отвечавших и подтвержденных несколькими источниками endpoints часто эффективнее, чем простое увеличение connections.
Точный ответ для 2c4g или 4c8g дает только нагрузочный тест в реальном регионе с p50/p95/p99 latency, очередями и разбором failure classes.
Эскиз реализации
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Путать 1 000 discovered hashes с 1 000 успешных Metadata.
- Считать concurrency только по среднему latency.
- Добавлять workers без качественного Peer supply.
- Обещать throughput по конфигурации VPS без сетевого benchmark.
Связанные статьи BT9G Labs
- Почему получение Torrent Metadata не удается: 10 реальных причин и правильная модель retry
- Архитектура высокопроизводительного DHT crawler: очереди, backpressure и границы ресурсов
- Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
- Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler
Источники
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.