BT9G LABS / DHT Deep Dive #19
Как построить BitTorrent search index: DHT → Metadata → Elasticsearch
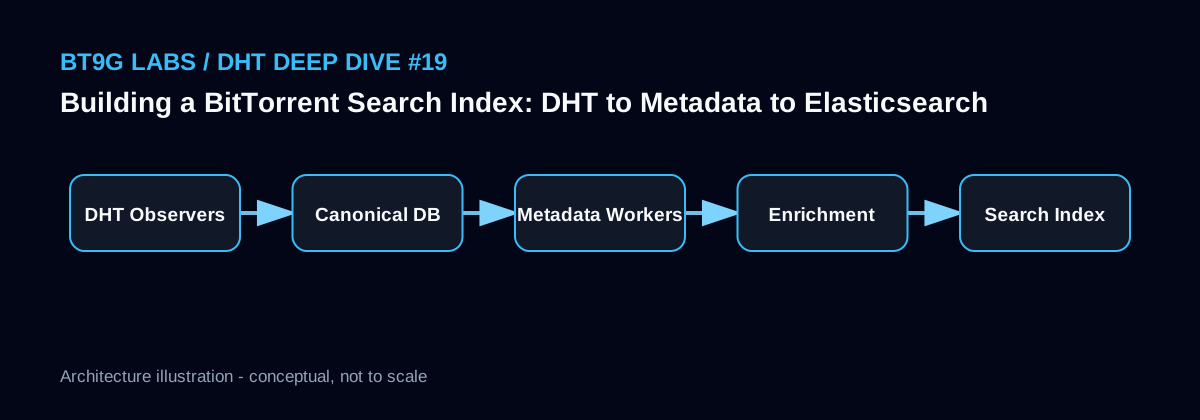
End-to-end архитектура преобразования DHT observations в проверенные и полнотекстово индексируемые Metadata documents.
BT9G Labs / DHT Deep Dive #19. Отделяем network discovery, canonical storage, enrichment и Elasticsearch, чтобы поисковый слой оставался производным, а не источником истины.
Краткое резюме
- Тема: Как построить BitTorrent search index: DHT → Metadata → Elasticsearch
- Ключевые слова: BitTorrent search engine, Elasticsearch, DHT pipeline, Metadata indexing, search architecture
- Для кого: backend-разработчики, исследователи протоколов, инженеры поисковых систем и разработчики BitTorrent-клиентов
- Цель: Объяснить механизм достаточно точно, чтобы на его основе можно было принимать реальные архитектурные решения для краулинга, индексации и поиска.
Системная схема
Search index только после validation
DHT дает идентификатор и сетевые сигналы, но searchable filenames должны происходить из проверенного Metadata. Без проверки мусорный или ошибочный Peer может загрязнить Elasticsearch. Правильный pipeline выглядит как discovery → hash ledger → Peer candidates → Metadata acquisition → identity validation → canonical store → enrichment → search index.
Каждый переход имеет собственные метрики и failure semantics.
Canonical store и Elasticsearch решают разные задачи
Canonical storage хранит подтвержденные байты/структуру Metadata и долгосрочное состояние. Elasticsearch — производное представление для tokenization, fuzzy search, facets и ranking. Если mapping или analyzer меняются, ES должен быть перестраиваем из canonical data.
Это снимает зависимость от одного search cluster как от единственной копии истины.
Enrichment и ranking
Language detection, category, file type, normalized title и safety labels полезны, но являются recomputable derived fields и не должны менять content identity. Ranking лучше строить из нескольких сигналов: text relevance, freshness, validated metadata quality, recent network activity и coverage.
Ни один сомнительный activity counter не должен маскироваться под точную глобальную популярность.
Эскиз реализации
{
  "infohash": "...",
  "title": "Example Release",
  "total_size": 734003200,
  "file_count": 12,
  "extensions": ["mkv", "srt"],
  "first_seen": "...",
  "last_seen": "...",
  "metadata_verified": true,
  "activity_score": 0.73
}
Инженерные заметки BT9G Labs
Для индексатора уровня BT9G важнее не максимальное число событий, а правильное разделение идентичности контента, краткоживущих сетевых наблюдений, состояния сбора и поискового представления. Поля, полученные из DHT или от Peer, должны иметь источник и временную метку. Метрики стоит вести по этапам: discovery, соединение, handshake, поддержка расширений, получение Metadata, проверка, сохранение и индексация. Это позволяет видеть реальное узкое место системы, а не списывать все неудачи на «нестабильную сеть».
Типичные ошибки
- Индексировать непроверенные сетевые данные напрямую.
- Использовать Elasticsearch как единственный canonical database.
- Позволять enrichment менять InfoHash или исходные file paths.
- Ранжировать только по одному activity counter.
Связанные статьи BT9G Labs
- Как дедуплицировать миллиарды InfoHash и не тратить ресурсы на повторный Metadata fetch
- Почему неудачные InfoHash стоит хранить: долгосрочный retry scheduler
- Как BT9G может масштабировать индексацию BitTorrent Metadata: эталонная DHT-архитектура
Источники
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 48 - Tracker Protocol Extension: Scrape
Материал описывает публичное поведение протоколов BitTorrent для инженерных и исследовательских целей и не означает, что любой наблюдаемый Swarm доступен, корректен или разрешен к распространению.