
BT9G LABS / DHT em profundidade #18
Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo
Preserve hashes históricos, aplique backoff em Swarms frios e reative rapidamente quando surgir atividade nova.
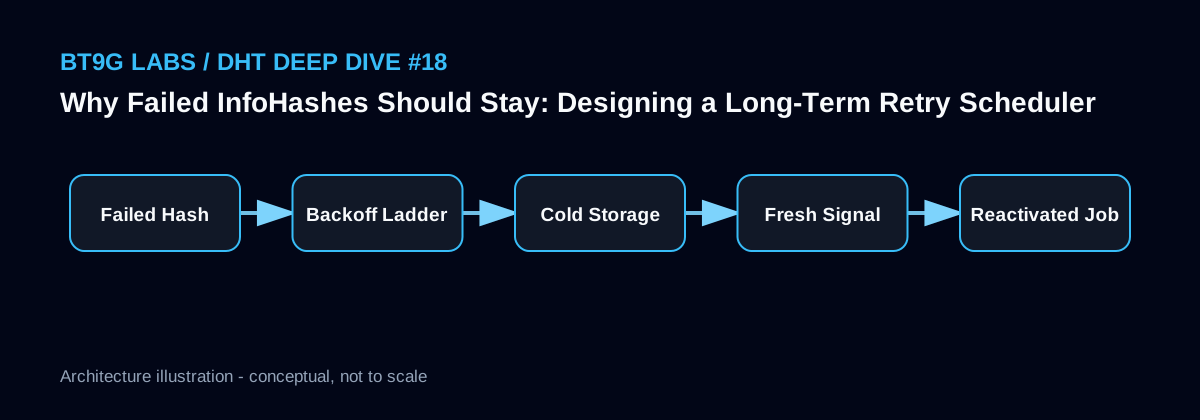
BT9G Labs / DHT Deep Dive #18. Uma falha hoje é uma observação temporal, não um tombstone permanente; preserve estado barato e ajuste a frequência de tentativas caras.
Resumo rápido
- Tema: Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo
- Palavras-chave: InfoHash retry, exponential backoff, cold swarm, scheduler, Metadata retry
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Failure timestamp não é tombstone
Um InfoHash sem Metadata hoje pode voltar a ter Peer em algumas semanas. Apagar a chave elimina contexto histórico. É barato manter um registro compacto e muito mais caro repetir conexões, então faz sentido preservar a identidade e alongar o intervalo de retry.
O ledger histórico se torna um ativo acumulativo.
Backoff deve seguir a classe do erro
DHT timeout, connection refused, ut_metadata unsupported e hash mismatch significam coisas diferentes. Erros temporários podem ser repetidos logo; hashes sem Peer por meses podem ir para exponential backoff de dias.
A política precisa de limite máximo e condições de wake-up para não abandonar tarefas permanentemente.
Atividade fresca vence pessimismo antigo
Novo announce, Peer candidate ou sinal de Tracker deve adiantar next_attempt_at, mesmo que exista um backoff longo. A retry queue também deve ser durable, com mecanismo de claim/lease para sobreviver a deploys e crashes sem duplicar trabalho em massa.
Sinais recentes devem pesar mais que falhas antigas.
Esboço de implementação
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Apagar o InfoHash após a primeira falha.
- Usar o mesmo retry interval para todos os erros.
- Ignorar atividade recente.
- Manter a retry queue de longo prazo somente em RAM.
Artigos relacionados do BT9G Labs
- O que é necessário para obter 1.000+ Torrent Metadata por minuto
- Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
- Construindo um índice de busca BitTorrent: de DHT a Metadata e Elasticsearch
- Como o BT9G pode indexar BitTorrent Metadata em escala: arquitetura DHT de referência
Referências
Próximo artigo: Construindo um índice de busca BitTorrent: de DHT a Metadata e Elasticsearch →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.