BT9G LABS / DHT em profundidade #15
Arquitetura de um DHT Crawler de alto desempenho: filas e backpressure
Observação DHT de alto throughput com UDP eficiente, memória limitada e Metadata workers desacoplados.
BT9G Labs / DHT Deep Dive #15. Desempenho vem de separação de responsabilidades, limites de recursos e métricas — não de goroutines infinitas.
Resumo rápido
- Tema: Arquitetura de um DHT Crawler de alto desempenho: filas e backpressure
- Palavras-chave: DHT crawler architecture, backpressure, UDP, queues, high throughput
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Separar packet plane e work plane
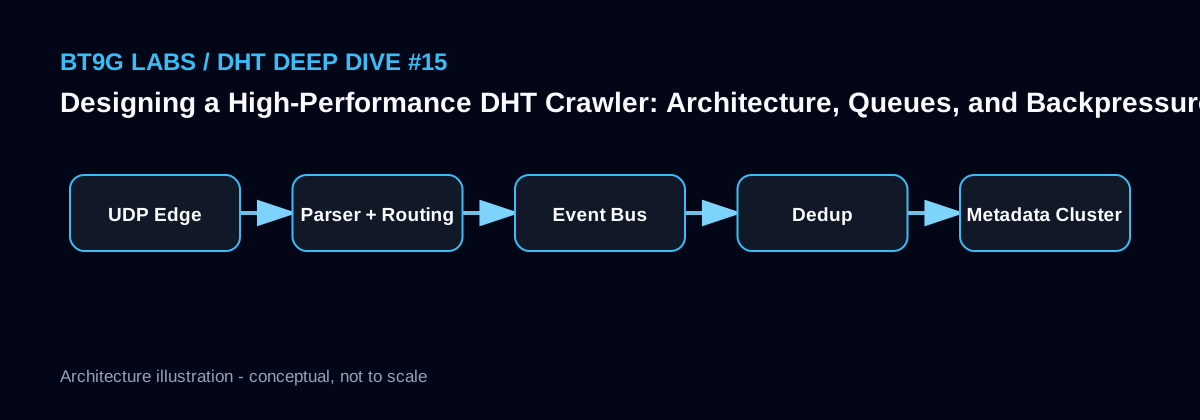
O receive path UDP deve validar KRPC, rotear transaction IDs, atualizar estado leve e enfileirar eventos em uma bounded queue. Conexões de Metadata, DB writes e search indexing ficam em workers separados.
Isso evita que downstream lento bloqueie o socket reader e permite escalar cada estágio de forma independente.
Tudo precisa de limites
Queue, goroutine e retry ilimitados apenas adiam o problema até o OOM. Limite outstanding RPC, discovery queue, Metadata jobs, conexões por host e retry heap. Quando o downstream não acompanha, reduza active crawling, consolide duplicados ou descarte reobservações de baixo valor.
Backpressure faz parte do funcionamento normal.
Medir antes de otimizar
Métricas úteis incluem packet rate, query success, unique hash rate, Peer connect success, suporte BEP 10, Metadata success, completion latency e queue wait. Isso revela se o gargalo está em sockets, região de rede, timeout, qualidade dos Peer, storage ou indexing.
Escalar sem ownership pode apenas multiplicar trabalho duplicado.
Esboço de implementação
[UDP sockets]
     |
     v
[KRPC + routing] ---> metrics
     |
     v
[bounded hash-event queue]
     |
     v
[dedup / scheduler] ---> [retry store]
     |
     v
[metadata workers] ---> [validation] ---> [DB / Search]
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Usar goroutines ilimitadas como estratégia de escala.
- Executar operações lentas no hot path UDP.
- Duplicar serviços sem ownership e dedup.
- Ajustar timeout e concurrency sem métricas por estágio.
Artigos relacionados do BT9G Labs
- Seeders e Leechers: o que os números significam e como são medidos
- Por que a obtenção de Torrent Metadata falha: 10 causas reais e um modelo de retry melhor
- O que é necessário para obter 1.000+ Torrent Metadata por minuto
- Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
Referências
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
Próximo artigo: O que é necessário para obter 1.000+ Torrent Metadata por minuto →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.