
BT9G LABS / DHT em profundidade #16
O que é necessário para obter 1.000+ Torrent Metadata por minuto
Capacity planning de um pipeline de Metadata baseado em sucesso real, Peer discovery, timeout budget e concurrency.
BT9G Labs / DHT Deep Dive #16. Dimensione a partir de resultados validados, e não do número de requests enviados.
Resumo rápido
- Tema: O que é necessário para obter 1.000+ Torrent Metadata por minuto
- Palavras-chave: 1000 metadata/min, Metadata pipeline, concurrency, Little's Law, BitTorrent crawler
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Comece pelo throughput de sucesso
1.000 Metadata/min equivalem a cerca de 16,7 sucessos/s. Se apenas 20% das tentativas chegam a Metadata validada, talvez sejam necessárias mais de 80 tentativas úteis por segundo. Discovery rate de InfoHash é uma métrica diferente.
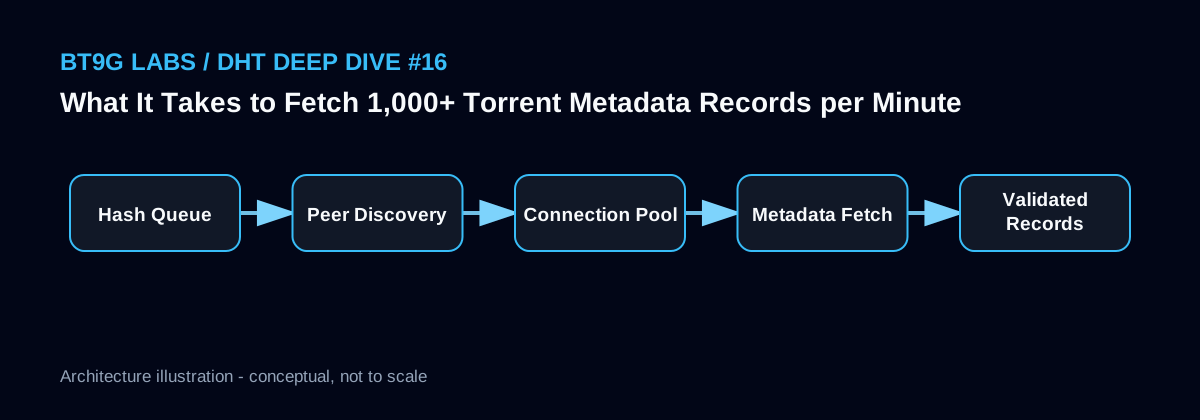
Meça a conversão hash → Peer candidates → connected → extension supported → validated Metadata.
Little's Law como primeira estimativa
Se cada tentativa ocupa em média 5 segundos a 80 attempts/s, haverá cerca de 400 tarefas in-flight. A cauda de timeout aumenta a necessidade real. Porém aumentar concurrency sem fim encontra limites de file descriptors, NAT/conntrack, bandwidth, CPU e Peer remotos.
O cálculo orienta, mas não substitui benchmark.
Qualidade de Peer e limites do host
Mais workers não ajudam se upstream fornece poucos Peer alcançáveis. Priorizar atividade recente, endpoints previamente bem-sucedidos e múltiplas fontes pode ser melhor do que abrir conexões indiscriminadamente.
O desempenho de 2c4g ou 4c8g deve ser testado na região real com p50/p95/p99, queue e failure classes.
Esboço de implementação
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Confundir 1.000 hashes descobertos com 1.000 Metadata válidas.
- Calcular concurrency só pela latência média.
- Adicionar workers sem bons Peer candidates.
- Prometer throughput pelo tamanho do VPS sem benchmark.
Artigos relacionados do BT9G Labs
- Por que a obtenção de Torrent Metadata falha: 10 causas reais e um modelo de retry melhor
- Arquitetura de um DHT Crawler de alto desempenho: filas e backpressure
- Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
- Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo
Referências
Próximo artigo: Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.