BT9G LABS / DHT em profundidade #17
Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
Dedup multicamada com exact keys, Bloom filter, hot cache e estado durable para DHT ingestion em grande escala.
BT9G Labs / DHT Deep Dive #17. Deduplication é um subsistema essencial que define o custo do crawler muito antes de chegar a bilhões de chaves.
Resumo rápido
- Tema: Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
- Palavras-chave: InfoHash deduplication, Bloom filter, Redis, large-scale DHT, Metadata scheduler
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
Dedup multicamada
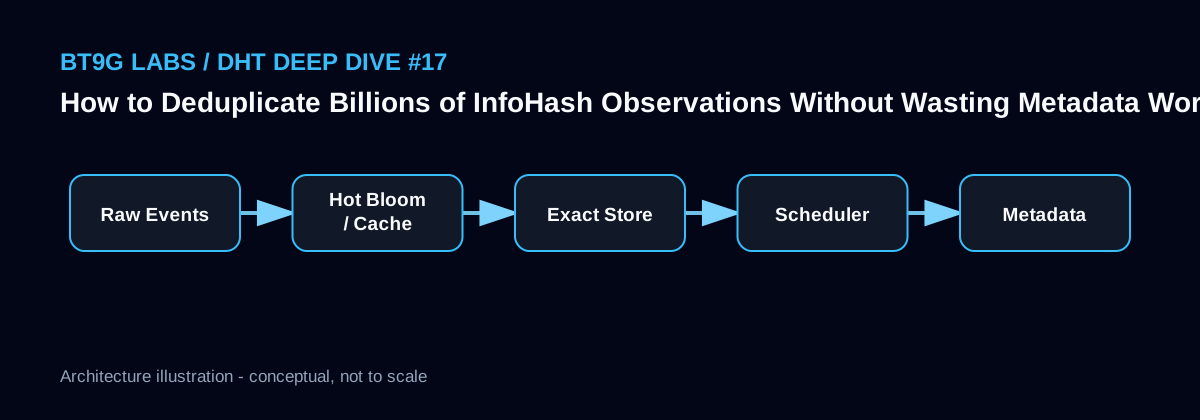
Um InfoHash popular aparece repetidamente. Consultar a DB principal e criar Metadata job para cada evento desperdiça I/O e conexões. Uma sequência prática é process-local recent set → Bloom filter → hot cache → durable exact store.
Cada camada filtra repetições antes de operações mais caras, enquanto o store exato continua como source of truth.
Bloom filter não é a verdade
Bloom filter é compacto, rápido e não produz false negative, mas pode produzir false positive. É ótimo para responder “provavelmente já vimos” e reduzir leituras, porém não deve eliminar para sempre uma chave nova sem confirmação exata.
O custo de um false positive pode ser perder conteúdo novo.
Existence e scheduling state são diferentes
Saber que o hash já foi visto não significa que sua Metadata esteja completa ou que nunca precise de retry. O registro durable deve separar first_seen, last_seen, metadata_state, retry_state e activity.
Para bilhões de chaves, partitioning por hash, exact lookup por primary key e tamanho de índices devem ser planejados cedo.
Esboço de implementação
CREATE TABLE infohash_state (
  hash VARBINARY(32) NOT NULL,
  hash_type TINYINT NOT NULL,
  first_seen DATETIME NOT NULL,
  last_seen DATETIME NOT NULL,
  seen_count BIGINT NOT NULL,
  metadata_status TINYINT NOT NULL,
  next_retry DATETIME NULL,
  PRIMARY KEY(hash_type, hash)
);
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Consultar a DB principal para cada evento bruto.
- Usar Bloom filter como source of truth absoluto.
- Guardar apenas
seen=truesem estado de Metadata/retry. - Deixar partitioning para quando já houver bilhões de registros.
Artigos relacionados do BT9G Labs
- Arquitetura de um DHT Crawler de alto desempenho: filas e backpressure
- O que é necessário para obter 1.000+ Torrent Metadata por minuto
- Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo
- Construindo um índice de busca BitTorrent: de DHT a Metadata e Elasticsearch
Referências
Próximo artigo: Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo →
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.