BT9G LABS / DHT em profundidade #19
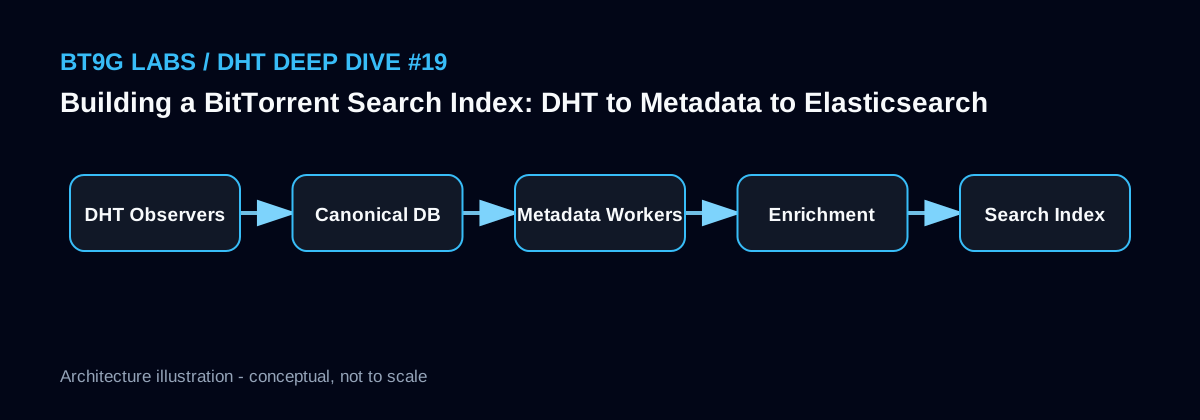
Construindo um índice de busca BitTorrent: de DHT a Metadata e Elasticsearch
Arquitetura end-to-end para transformar observações DHT em documentos de Metadata validados e pesquisáveis.
BT9G Labs / DHT Deep Dive #19. Separe discovery, canonical storage, enrichment e Elasticsearch para manter a camada de busca derivada e reconstruível.
Resumo rápido
- Tema: Construindo um índice de busca BitTorrent: de DHT a Metadata e Elasticsearch
- Palavras-chave: BitTorrent search engine, Elasticsearch, DHT pipeline, Metadata indexing, search architecture
- Público: engenheiros backend, pesquisadores de protocolos, engenheiros de busca e implementadores de BitTorrent
- Objetivo: Explicar o mecanismo com precisão suficiente para orientar decisões reais de arquitetura de crawling, indexação e busca.
Visão do sistema
O search index deve vir depois da validação
A DHT fornece identidade e sinais de rede, mas nomes e caminhos pesquisáveis devem vir de Metadata validada. Indexar dados não verificados diretamente permite que erros ou Peer maliciosos contaminem o Elasticsearch.
Um pipeline sólido é discovery → hash ledger → Peer candidates → Metadata acquisition → identity validation → canonical store → enrichment → search index.
Canonical store e search store têm papéis distintos
O canonical layer mantém Metadata confirmada e estado histórico. Elasticsearch é uma representação derivada para tokenization, fuzzy search, facets e ranking. Quando mappings ou analyzers mudam, o índice deve poder ser reconstruído a partir dos dados canônicos.
Assim ES não se torna a única cópia de verdade.
Enrichment e ranking
Language detection, categoria, file type, normalized title e safety labels são campos derivados e recalculáveis; não devem modificar InfoHash nem file paths originais. O ranking pode combinar text relevance, freshness, qualidade da Metadata e atividade recente.
Uma métrica incerta de atividade não deve ser apresentada como popularidade global exata.
Esboço de implementação
{
  "infohash": "...",
  "title": "Example Release",
  "total_size": 734003200,
  "file_count": 12,
  "extensions": ["mkv", "srt"],
  "first_seen": "...",
  "last_seen": "...",
  "metadata_verified": true,
  "activity_score": 0.73
}
Notas de engenharia do BT9G Labs
Em um indexador como o BT9G, é mais importante separar corretamente a identidade do conteúdo, observações de rede de curta duração, estado de aquisição e documentos de busca do que maximizar o número bruto de eventos. Campos derivados de DHT ou de um Peer devem manter origem e timestamp, e as métricas devem ser divididas por etapas: discovery, conexão, handshake, suporte a extensões, obtenção de Metadata, validação, armazenamento e indexação.
Erros comuns
- Indexar dados DHT não validados diretamente.
- Usar Elasticsearch como único banco canônico.
- Permitir que enrichment altere a identidade do conteúdo.
- Rankear tudo por um único contador de atividade.
Artigos relacionados do BT9G Labs
- Como deduplicar bilhões de InfoHash sem repetir trabalho de Metadata
- Por que manter InfoHash que falharam: design de um Retry Scheduler de longo prazo
- Como o BT9G pode indexar BitTorrent Metadata em escala: arquitetura DHT de referência
Referências
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 48 - Tracker Protocol Extension: Scrape
Este artigo descreve o comportamento de protocolos públicos do BitTorrent para fins de engenharia e pesquisa; não implica que todo Swarm observado esteja disponível, seja válido ou autorizado para redistribuição.