
BT9G LABS / DHT a fondo #18
Por qué conviene conservar InfoHash fallidos: diseño de un Retry Scheduler a largo plazo
Conserva hashes históricos, aplica backoff a Swarm fríos y reactiva rápidamente cuando aparece actividad nueva.
BT9G Labs / DHT Deep Dive #18. Un fallo hoy es una observación temporal, no un tombstone permanente; conserva estado barato y ajusta la frecuencia de intentos caros.
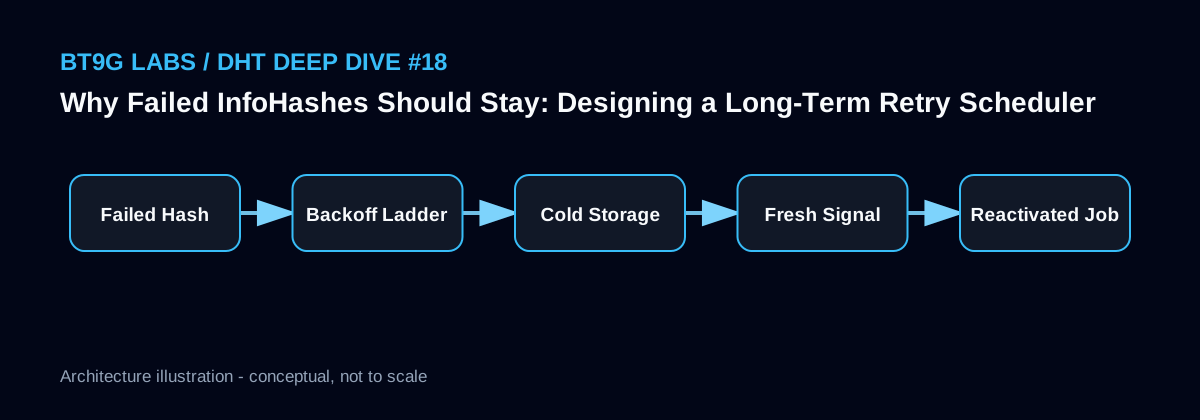
Resumen rápido
- Tema: Por qué conviene conservar InfoHash fallidos: diseño de un Retry Scheduler a largo plazo
- Palabras clave: InfoHash retry, exponential backoff, cold swarm, scheduler, Metadata retry
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Un failure timestamp no es una tumba
Un InfoHash sin Metadata hoy puede revivir cuando aparezca un nuevo Peer dentro de semanas. Borrar la clave elimina contexto histórico. Es barato guardar un registro pequeño y mucho más caro hacer conexiones repetidas, por lo que conviene conservar la identidad y espaciar intentos.
El ledger histórico se convierte así en un activo acumulativo.
Backoff según la clase de error
DHT timeout, connection refused, ut_metadata unsupported y hash mismatch tienen significados diferentes. Errores transitorios pueden repetirse pronto; hashes sin Peer durante meses pueden pasar a días de exponential backoff.
La política necesita un máximo y condiciones de wake-up para no abandonar una tarea para siempre.
Actividad fresca supera al pesimismo antiguo
Un announce nuevo, un nuevo Peer candidate o actividad de Tracker deberían adelantar next_attempt_at aunque exista un backoff largo. La retry queue también debe ser durable, con claim/lease para sobrevivir deploys y crashes sin duplicar masivamente trabajo.
La señal más reciente debe pesar más que un fallo de meses atrás.
Esquema de implementación
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Borrar un InfoHash tras el primer fallo.
- Usar el mismo retry interval para todas las clases de error.
- No reaccionar a actividad reciente.
- Mantener una cola de largo plazo solo en RAM.
Artículos relacionados de BT9G Labs
- Qué hace falta para obtener 1.000+ Torrent Metadata por minuto
- Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
- Construir un índice de búsqueda BitTorrent: de DHT a Metadata y Elasticsearch
- Cómo BT9G puede indexar BitTorrent Metadata a escala: arquitectura DHT de referencia
Referencias
Siguiente artículo: Construir un índice de búsqueda BitTorrent: de DHT a Metadata y Elasticsearch →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.