
BT9G LABS / DHT a fondo #16
Qué hace falta para obtener 1.000+ Torrent Metadata por minuto
Capacity planning de un pipeline de Metadata a partir de éxito real, Peer discovery, timeouts y concurrency.
BT9G Labs / DHT Deep Dive #16. Calcula la capacidad desde resultados validados, no desde el número de requests enviados.
Resumen rápido
- Tema: Qué hace falta para obtener 1.000+ Torrent Metadata por minuto
- Palabras clave: 1000 metadata/min, Metadata pipeline, concurrency, Little's Law, BitTorrent crawler
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Empezar por el throughput de éxito
1.000 Metadata/min son unos 16,7 éxitos/s. Si solo el 20% de intentos termina en Metadata validada, podrían requerirse más de 80 intentos útiles por segundo. La tasa de discovery de InfoHash es una métrica diferente.
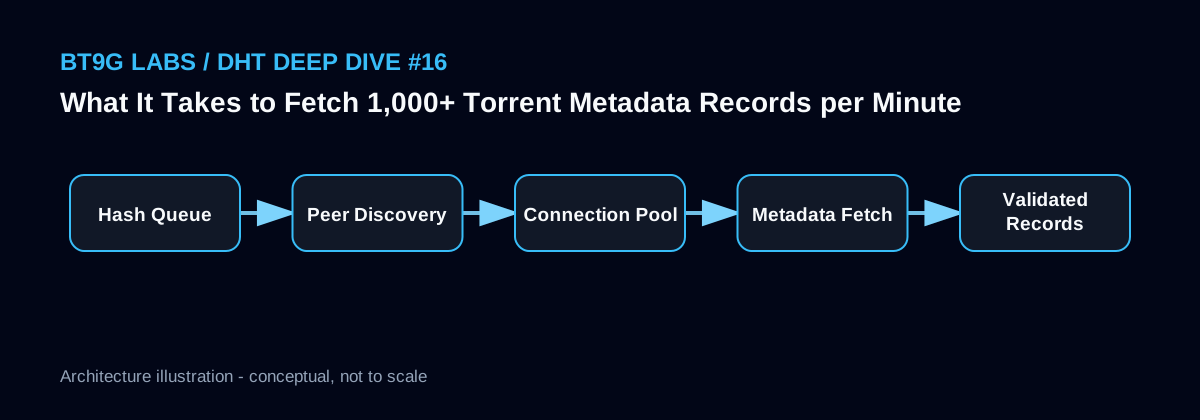
Hay que medir la conversión hash → Peer candidates → connected → extension supported → validated Metadata.
Little's Law para una primera estimación
Si cada intento ocupa en promedio 5 segundos a 80 attempts/s, habrá unas 400 tareas concurrentes en vuelo. El tail de timeout aumenta el requisito real. Sin embargo, aumentar concurrency indefinidamente choca con file descriptors, NAT/conntrack, bandwidth, CPU y límites de los Peer remotos.
El cálculo orienta, pero no sustituye un benchmark.
Calidad de Peer y límites del host
Más Metadata workers no sirven si upstream entrega pocos Peer alcanzables. Priorizar actividad reciente, endpoints previamente exitosos y señales de varias fuentes puede ser más efectivo que abrir conexiones sin control.
El rendimiento real de 2c4g o 4c8g debe medirse en la región de despliegue con p50/p95/p99, colas y failure classes.
Esquema de implementación
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Confundir 1.000 hashes descubiertos con 1.000 Metadata exitosas.
- Calcular concurrency solo con latencia media.
- Añadir workers sin suficiente suministro de buenos Peer.
- Prometer throughput por especificación VPS sin benchmark real.
Artículos relacionados de BT9G Labs
- Por qué falla la obtención de Torrent Metadata: 10 causas reales y un mejor modelo de retry
- Diseño de un DHT Crawler de alto rendimiento: arquitectura, colas y backpressure
- Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
- Por qué conviene conservar InfoHash fallidos: diseño de un Retry Scheduler a largo plazo
Referencias
Siguiente artículo: Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.