BT9G LABS / DHT a fondo #19
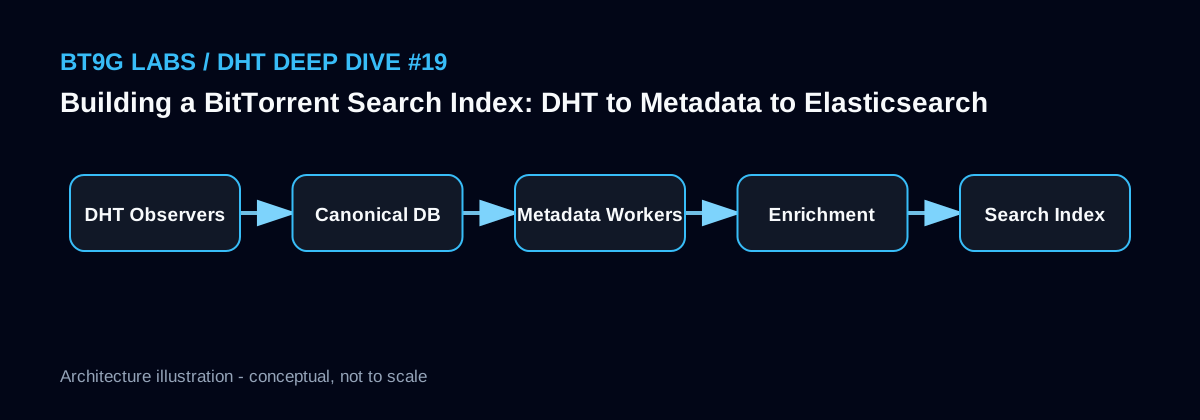
Construir un índice de búsqueda BitTorrent: de DHT a Metadata y Elasticsearch
Arquitectura end-to-end para convertir observaciones DHT en documentos de Metadata validados y buscables.
BT9G Labs / DHT Deep Dive #19. Separa discovery, canonical storage, enrichment y Elasticsearch para que la capa de búsqueda sea derivada y reconstruible.
Resumen rápido
- Tema: Construir un índice de búsqueda BitTorrent: de DHT a Metadata y Elasticsearch
- Palabras clave: BitTorrent search engine, Elasticsearch, DHT pipeline, Metadata indexing, search architecture
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
El índice debe estar después de la validación
DHT aporta identidad y señales de red, pero los nombres y rutas buscables deben provenir de Metadata validada. Indexar directamente datos no verificados permite que errores o Peer maliciosos contaminen Elasticsearch.
Un pipeline sólido es discovery → hash ledger → Peer candidates → Metadata acquisition → identity validation → canonical store → enrichment → search index.
Canonical store y search store tienen funciones distintas
El canonical layer conserva Metadata confirmada y estado histórico. Elasticsearch es una representación derivada para tokenization, fuzzy search, facets y ranking. Cuando cambian mappings o analyzers, el search index debería poder reconstruirse desde datos canónicos.
Así ES no se convierte en la única copia de verdad.
Enrichment y ranking
Language detection, categoría, file type, normalized title y safety labels son campos derivados y recalculables; no deben cambiar InfoHash ni file paths originales. El ranking puede combinar text relevance, freshness, calidad de Metadata y actividad reciente.
Una métrica incierta de actividad no debe presentarse como popularidad global exacta.
Esquema de implementación
{
  "infohash": "...",
  "title": "Example Release",
  "total_size": 734003200,
  "file_count": 12,
  "extensions": ["mkv", "srt"],
  "first_seen": "...",
  "last_seen": "...",
  "metadata_verified": true,
  "activity_score": 0.73
}
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Indexar datos DHT no validados directamente.
- Usar Elasticsearch como única base canónica.
- Permitir que enrichment modifique la identidad del contenido.
- Rankear todo con un solo contador de actividad.
Artículos relacionados de BT9G Labs
- Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
- Por qué conviene conservar InfoHash fallidos: diseño de un Retry Scheduler a largo plazo
- Cómo BT9G puede indexar BitTorrent Metadata a escala: arquitectura DHT de referencia
Referencias
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 48 - Tracker Protocol Extension: Scrape
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.