
BT9G LABS / DHT a fondo #15
Diseño de un DHT Crawler de alto rendimiento: arquitectura, colas y backpressure
Arquitectura para observación DHT de alto throughput con UDP eficiente, memoria acotada y Metadata workers desacoplados.
BT9G Labs / DHT Deep Dive #15. El rendimiento real proviene de separar responsabilidades, limitar recursos y medir cada etapa, no de crear goroutines sin límite.
Resumen rápido
- Tema: Diseño de un DHT Crawler de alto rendimiento: arquitectura, colas y backpressure
- Palabras clave: DHT crawler architecture, backpressure, UDP, queues, high throughput
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Separar packet plane y work plane
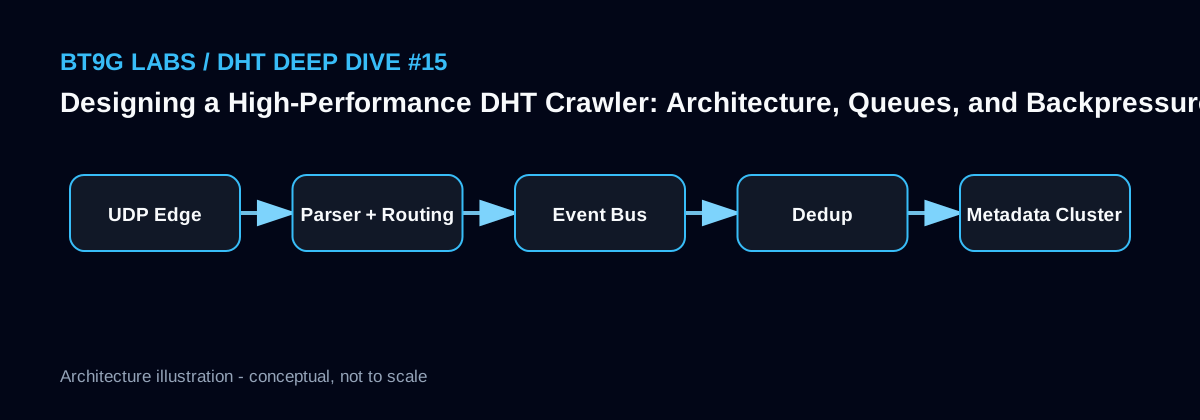
El receive path UDP debería limitarse a validar KRPC, enrutar transaction IDs, actualizar estado ligero y publicar eventos en una bounded queue. Conexiones de Metadata, escrituras de DB e indexación deben ejecutarse en workers separados.
Así un downstream lento no bloquea el socket reader y cada etapa puede escalar de manera independiente.
Todo necesita límites
Colas, goroutines y retries ilimitados solo posponen el fallo hasta un OOM. Conviene limitar outstanding RPC, discovery queue, Metadata jobs, conexiones por host y retry heap. Cuando el downstream no alcanza, se reduce crawling activo, se fusionan duplicados o se descartan reobservaciones de bajo valor.
Backpressure forma parte del diseño normal.
Medir antes de optimizar
Métricas útiles incluyen packet rate, query success, unique hash rate, Peer connect success, soporte BEP 10, Metadata success, completion latency y queue wait. Solo así se distingue si el cuello está en sockets, región de red, timeout, calidad de Peer, storage o search indexing.
Escalar sin un modelo de ownership puede multiplicar trabajo duplicado.
Esquema de implementación
[UDP sockets]
     |
     v
[KRPC + routing] ---> metrics
     |
     v
[bounded hash-event queue]
     |
     v
[dedup / scheduler] ---> [retry store]
     |
     v
[metadata workers] ---> [validation] ---> [DB / Search]
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Usar goroutines ilimitadas como estrategia de escalado.
- Hacer operaciones lentas dentro del hot path UDP.
- Clonar servicios sin definir ownership y dedup.
- Ajustar timeouts sin métricas por etapa.
Artículos relacionados de BT9G Labs
- Seeders y Leechers: qué significan los números y cómo se miden
- Por qué falla la obtención de Torrent Metadata: 10 causas reales y un mejor modelo de retry
- Qué hace falta para obtener 1.000+ Torrent Metadata por minuto
- Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
Referencias
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
Siguiente artículo: Qué hace falta para obtener 1.000+ Torrent Metadata por minuto →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.