BT9G LABS / DHT a fondo #17
Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
Diseño multicapa con exact keys, Bloom filter, hot cache y estado durable para ingestion DHT a gran escala.
BT9G Labs / DHT Deep Dive #17. Deduplication es un subsistema de primera clase que define la economía del crawler mucho antes de llegar a mil millones de claves.
Resumen rápido
- Tema: Cómo deduplicar miles de millones de InfoHash sin repetir trabajo de Metadata
- Palabras clave: InfoHash deduplication, Bloom filter, Redis, large-scale DHT, Metadata scheduler
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Dedup multicapa
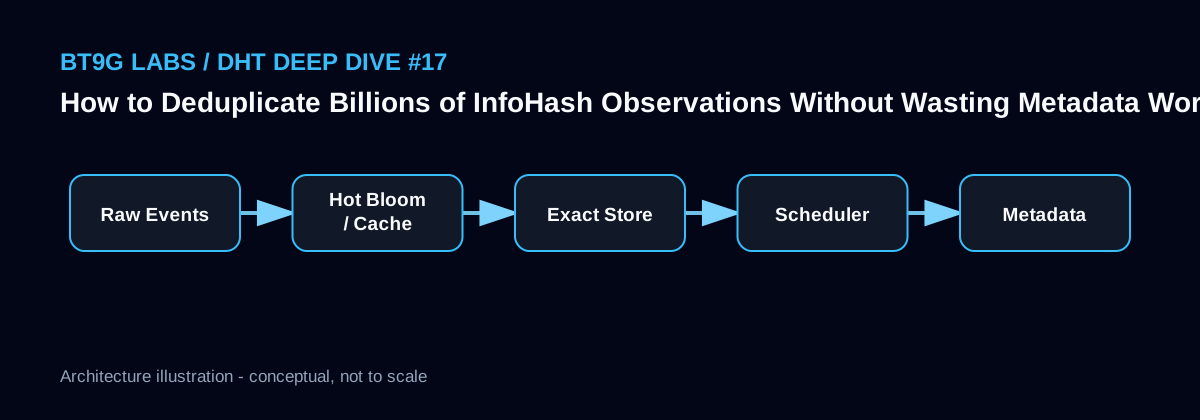
Un InfoHash popular aparece una y otra vez. Consultar la DB principal y crear un Metadata job por cada evento desperdicia I/O y conexiones. Una cadena práctica es process-local recent set → Bloom filter → hot cache → durable exact store.
Cada capa elimina repeticiones antes de llegar a operaciones más caras, mientras el store exacto sigue siendo source of truth.
Bloom filter no es la verdad
Un Bloom filter es compacto y rápido, sin false negatives, pero sí con false positives. Funciona bien para decidir «probablemente ya lo vimos» y ahorrar lecturas, pero no debería descartar permanentemente una clave nueva sin confirmación exacta.
El coste de un falso positivo puede ser perder contenido nuevo.
Existence y scheduling state son distintos
Saber que un hash existe no dice si su Metadata ya se obtuvo o si debe reintentarse. Un durable record debería separar first_seen, last_seen, metadata_state, retry_state y activity.
A escala de miles de millones conviene diseñar pronto partitioning por hash, exact lookup por clave primaria y el tamaño de índices/backups.
Esquema de implementación
CREATE TABLE infohash_state (
  hash VARBINARY(32) NOT NULL,
  hash_type TINYINT NOT NULL,
  first_seen DATETIME NOT NULL,
  last_seen DATETIME NOT NULL,
  seen_count BIGINT NOT NULL,
  metadata_status TINYINT NOT NULL,
  next_retry DATETIME NULL,
  PRIMARY KEY(hash_type, hash)
);
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Consultar la DB principal por cada evento bruto.
- Usar Bloom filter como source of truth absoluto.
- Guardar solo
seen=truesin estados de Metadata/retry. - Esperar a mil millones de filas para diseñar partitioning.
Artículos relacionados de BT9G Labs
- Diseño de un DHT Crawler de alto rendimiento: arquitectura, colas y backpressure
- Qué hace falta para obtener 1.000+ Torrent Metadata por minuto
- Por qué conviene conservar InfoHash fallidos: diseño de un Retry Scheduler a largo plazo
- Construir un índice de búsqueda BitTorrent: de DHT a Metadata y Elasticsearch
Referencias
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.