BT9G LABS / DHT 深度解析 #18
為甚麼失敗的 InfoHash 也應該保留:長期重試調度器設計
設計能夠保留歷史雜湊、對冷 Swarm 做退避,並在新活動出現時快速重新激活的長期 Metadata 重試系統。
BT9G Labs / DHT Deep Dive #18. 一次失敗只是某個時間點的網路結果,不應該成為永久墓碑;真正有效的是可衰減、可喚醒的重試狀態機。
快速摘要
- 主題: 為甚麼失敗的 InfoHash 也應該保留:長期重試調度器設計
- 核心關鍵詞: InfoHash 重試, exponential backoff, 冷 Swarm, 任務調度, Metadata retry
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
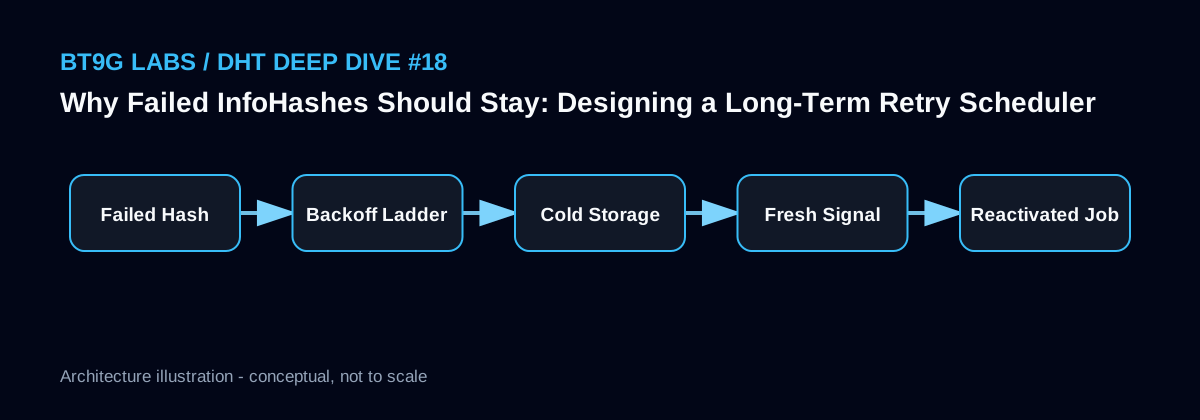
系統視圖
失敗時間戳不是墓碑
一個今天無法獲取 Metadata 的 InfoHash,幾周後可能因為新的 Seeder 或 Peer 出現而重新活躍。刪除這些失敗鍵會丟失長期資產,也意味著未來再次看到它時無法利用歷史狀態。
更合適的做法是保留 compact durable record,並把它放入越來越低頻的 retry schedule。存儲一個雜湊和少量狀態很便宜,持續高頻網路嘗試才昂貴。
Backoff 應該反映失敗類型
DHT lookup 暫時超時、Peer connect refused、對方不支持 ut_metadata、Metadata hash mismatch,這些錯誤的含義不同。網路短暫失敗可以較快重試,而連續多次“無任何 Peer”的冷資源可以指數退避到數天甚至更久。
分類重試能同時控製成本並提高成功率,避免一個固定間隔對所有任務都過於激進或過於遲緩。
新活動應覆蓋舊的悲觀判斷
如果一個雜湊已經進入很長的 backoff,但今天又從 DHT 觀察到新的 announce、Peer 或 Tracker 活動,就應該立即重新計算優先級。實時信號比幾個月前的失敗記錄更有價值。
系統可以把 activity event 視為 wake-up trigger,把 next_attempt_at 拉回當前窗口,並優先嘗試新的 Peer candidates。
重試佇列必須持久化
只把 retry heap 放在進程記憶體里,一旦部署或故障重啓就會丟失數百萬任務的下一次執行時間。大規模長期調度應該讓 durable store 保存狀態,由 worker 按時間窗口領取任務。
同時需要防止重復領取、處理 worker crash 和超時 lease,使同一個任務最終可以再次被調度但不會在正常情況下被大量重復執行。
實現示意
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 失敗一次就刪除 InfoHash。
- 所有錯誤都用同一重試週期。
- 新活動出現時仍機械等待舊 backoff。
- 只在記憶體中維護長期 retry queue。
相關 BT9G Labs 文章
- 每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構?
- 數十億 InfoHash 如何去重?避免重復 Metadata 工作的多層設計
- 構建 BitTorrent 搜索索引:從 DHT、Metadata 到 Elasticsearch
- BT9G 如何規模化索引 BitTorrent Metadata:參考 DHT 架構
參考資料
下一篇: 構建 BitTorrent 搜索索引:從 DHT、Metadata 到 Elasticsearch →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。