
BT9G LABS / DHT 深度解析 #16
每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構?
圍繞成功吞吐量、Peer discovery、連接成功率、timeout budget 和調度併發,反推千條/分鐘級 Metadata pipeline。
BT9G Labs / DHT Deep Dive #16. 從目標成功吞吐量倒推併發與資源,而不是把“發出多少請求”誤當成 Metadata 採集能力。
快速摘要
- 主題: 每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構?
- 核心關鍵詞: 1000 metadata/min, Metadata pipeline, 併發, Little's Law, BitTorrent crawler
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
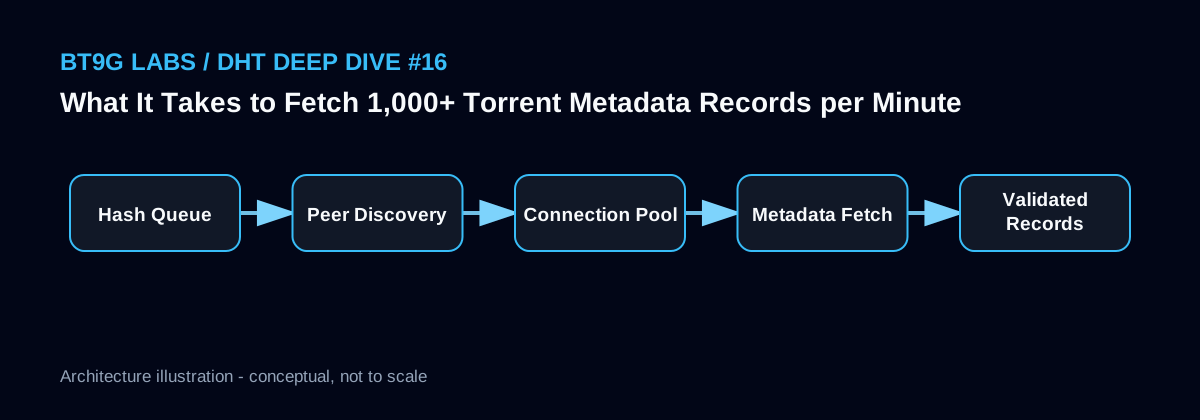
系統視圖
從成功吞吐量開始算
1,000 條/分鐘約等於 16.7 條成功 Metadata/秒。真正需要的連接嘗試數量取決於 Peer discovery 命中率、連接成功率、擴展支持率和 Metadata 完成率。如果端到端只有 20% 嘗試最終成功,那麼系統可能需要每秒發起八十多次有效嘗試。
因此“每分鐘收到多少 InfoHash”與“每分鐘拿到多少 Metadata”是完全不同的容量指標。
Little's Law 可以做第一輪估算
如果一個成功或失敗任務平均佔用 5 秒,而目標處理速率是 80 個嘗試/秒,那麼僅從平均值看就可能需要約 400 個併發中的任務。真實系統還要考慮長尾 timeout,因此併發預算通常更高。
不過無限提高併發不會線性增加吞吐量。socket、NAT、檔案描述符、出站帶寬、CPU 解析和遠端 Peer 限制都會讓收益遞減。
Peer discovery 可能才是隱藏瓶頸
Metadata worker 再快,如果上游只能提供很少的高質量 Peer candidates,最終成功率仍然上不去。應該分別統計每個 InfoHash 獲取到的 Peer 數、連接成功率、BEP 10 支持率和 ut_metadata 支持率。
優先選擇近期活躍、曾成功響應、來自多個獨立來源的 Peer,往往比盲目擴大連接併發更有效。
主機與網路資源邊界
2c4g 是否足夠不能只看理論併發。Go 本身可以管理很多 socket,但 DNS、NAT、conntrack、內核 UDP/TCP buffer、帶寬、磁盤寫入和資料庫 RTT 都可能先成為限制。
正確方式是在目標部署地區做壓測,並把 p50/p95/p99 時延、佇列長度和失敗原因一起記錄,再決定單機擴容還是橫向增加 worker。
實現示意
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 把發現 1,000 個 InfoHash 當成拿到 1,000 條 Metadata。
- 只按平均延遲計算併發而忽略長尾 timeout。
- Metadata worker 很多卻沒有足夠高質量 Peer。
- 不做真實網路壓測就承諾固定伺服器規格的吞吐量。
相關 BT9G Labs 文章
- 為甚麼 Torrent Metadata 獲取會失敗?10 個真實原因與更好的重試模型
- 高性能 DHT Crawler 架構:佇列、背壓與資源邊界
- 數十億 InfoHash 如何去重?避免重復 Metadata 工作的多層設計
- 為甚麼失敗的 InfoHash 也應該保留:長期重試調度器設計
參考資料
下一篇: 數十億 InfoHash 如何去重?避免重復 Metadata 工作的多層設計 →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。