BT9G LABS / DHT 深度解析 #15
高性能 DHT Crawler 架構:佇列、背壓與資源邊界
設計高吞吐量 DHT observation 系統:高效 UDP 處理、有界記憶體、職責分離、異步 Metadata worker 與 backpressure。
BT9G Labs / DHT Deep Dive #15. 真正高性能的 crawler 不是無限加 goroutine,而是把 packet plane、狀態、任務佇列和 Metadata acquisition 清晰解耦。
快速摘要
- 主題: 高性能 DHT Crawler 架構:佇列、背壓與資源邊界
- 核心關鍵詞: DHT crawler 架構, backpressure, UDP, 任務佇列, 高併發
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
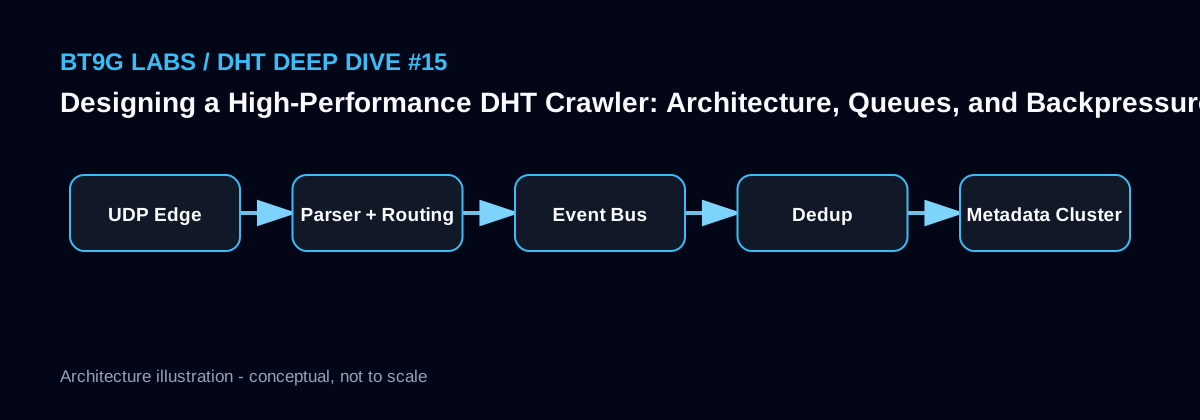
系統視圖
把 Packet Plane 與 Work Plane 分開
UDP 收包路徑追求的是低延遲和穩定吞吐量,因此只應該做協議驗證、transaction 路由、輕量狀態更新和事件入隊。Metadata 獲取、資料庫寫入、全文索引等高延遲任務必須放到獨立 worker。
這種分離讓 DHT discovery 即使遇到 Metadata 服務變慢也不至於直接阻塞 socket reader,同時也方便為不同階段設置獨立併發和監控指標。
所有東西都應該有上限
無限佇列、無限 goroutine、無限重試都只是在把故障推遲到記憶體耗盡的那一刻。高性能系統要為 outstanding KRPC、discovery queue、metadata queue、per-host connection、retry heap 等設置明確容量。
當下游落後時,系統需要 backpressure:可以降低主動探索速率、合併重復事件、丟棄低價值重復 observation,而不是繼續堆積不可處理的工作。
按職責分片,而不只是按 CPU 分片
DHT node worker、InfoHash ledger、Peer candidate service、Metadata worker 和 search indexer 的瓶頸完全不同。簡單把同一個進程複製十份,可能放大資料庫競爭或重復網路工作。
更好的分布式設計先定義 ownership:例如按 InfoHash 前綴分片調度狀態,或按 node identity 分配 routing responsibility,再根據各階段實際資源需求獨立擴縮容。
先測量,再優化
真正關鍵的指標包括 UDP packet rate、query success、routing convergence、unique hash rate、Peer connect success、BEP 10 support、Metadata success、平均完成時延和佇列等待時間。只看 CPU 利用率或“每秒收到多少雜湊”很難指導優化。
當某個階段的成功率和延遲被量化之後,才知道應該優化 socket、網路區域、timeout、Peer 選擇還是存儲。
實現示意
[UDP sockets]
     |
     v
[KRPC + routing] ---> metrics
     |
     v
[bounded hash-event queue]
     |
     v
[dedup / scheduler] ---> [retry store]
     |
     v
[metadata workers] ---> [validation] ---> [DB / Search]
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 用無限 goroutine 代替容量規劃。
- 讓 UDP reader 同步執行 Metadata 和資料庫任務。
- 只按機器 CPU 數複製相同服務而沒有明確 ownership。
- 沒有階段指標就憑感覺調整 timeout 和併發。
相關 BT9G Labs 文章
- Seeders 與 Leechers:數字代表甚麼,又是如何統計的?
- 為甚麼 Torrent Metadata 獲取會失敗?10 個真實原因與更好的重試模型
- 每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構?
- 數十億 InfoHash 如何去重?避免重復 Metadata 工作的多層設計
參考資料
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
下一篇: 每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構? →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。