
BT9G LABS / DHT 深度解析 #14
為甚麼 Torrent Metadata 獲取會失敗?10 個真實原因與更好的重試模型
診斷 Metadata timeout、冷 Swarm、擴展不支持、壞 Peer 和調度錯誤,並構建更合理的長期重試策略。
BT9G Labs / DHT Deep Dive #14. Metadata 獲取失敗是互聯網規模採集的正常狀態,關鍵是知道失敗發生在哪一層,以及何時值得再次嘗試。
快速摘要
- 主題: 為甚麼 Torrent Metadata 獲取會失敗?10 個真實原因與更好的重試模型
- 核心關鍵詞: Metadata timeout, Torrent Metadata, 重試策略, DHT crawler, Peer failure
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
系統視圖
互聯網規模下,失敗是常態
一個 InfoHash 被發現並不意味著此刻一定存在可連接、支持擴展且願意提供完整 Metadata 的 Peer。DHT 查詢可能超時,返回的 endpoints 可能已經失效,NAT 或防火牆會阻止連接,連接成功的客戶端也可能不支持 ut_metadata。
如果系統把所有這些情況都記成一個 failed=true,很快就無法判斷問題究竟來自 discovery、網路、協議還是內容本身。
十類常見失敗來源
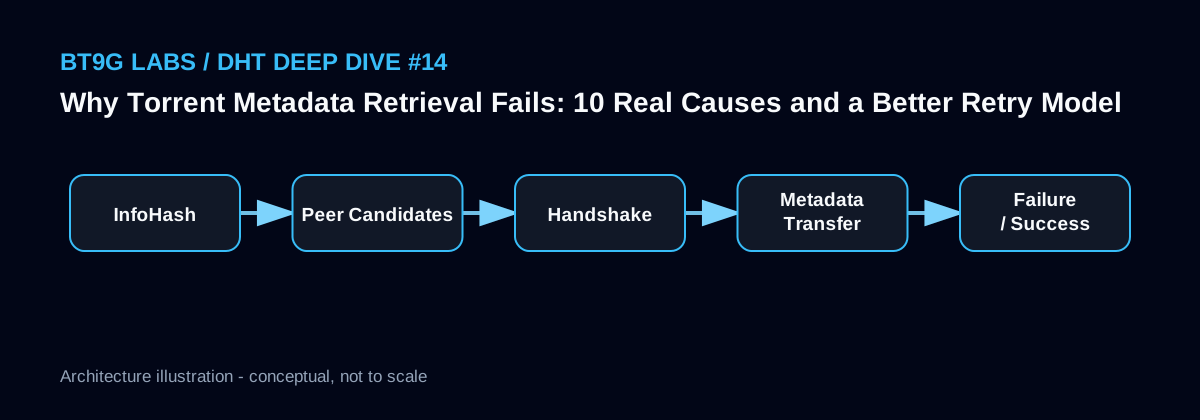
典型原因包括:當前沒有活躍 Peer;DHT 查詢未收斂;候選 Peer 已離線;端口不可達;握手 InfoHash 不匹配;對方不支持 BEP 10;支持擴展但不支持 ut_metadata;Metadata 傳輸中斷;收到錯誤或損壞 piece;以及本地併發、timeout 或調度參數過於激進。
真實系統往往同時遭遇多個原因,因此失敗分類應盡量貼近流水線階段。
區分短期失敗與長期冷卻
連接超時、Peer reject 等通常是短期事件,幾分鐘或幾小時後換一個 Peer 可能就成功;而連續數月沒有任何活動的雜湊則應該進入更長 backoff。指數退避可以顯著降低無效工作,但必須設置上限,避免永遠不再嘗試。
重試狀態最好包含 attempt_count、last_error_class、last_attempt_at、next_attempt_at 和 last_activity_at,而不是只有一個布爾失敗標誌。
新活動應能立即喚醒舊任務
即使一個雜湊已經因為多次失敗被推遲到很久以後,只要 crawler 又觀察到新的 announce_peer、get_peers 活動或其他可靠信號,就應該提升優先級並提前重試。新活動往往意味著網路中出現了新的可用 Peer。
這類 event-driven reactivation 能讓長期歷史庫在不持續燒資源的情況下保持“可復活”。
實現示意
NEW -> peer discovery
  no peers -> retry in 30m, 2h, 8h, 1d, 7d...
  peers found -> handshake
      no BEP10/9 -> try another peer
      transfer timeout -> peer penalty + retry
      valid metadata -> COMPLETE

fresh observation -> reduce backoff and re-queue
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 把所有失敗壓成一個錯誤碼。
- 失敗一次就永久放棄 InfoHash。
- 所有雜湊使用完全相同的固定重試間隔。
- 已經觀察到新活動,卻仍然等待舊的很長 backoff 到期。
相關 BT9G Labs 文章
- Tracker vs DHT vs PEX:三種 BitTorrent Peer 發現機制對比
- Seeders 與 Leechers:數字代表甚麼,又是如何統計的?
- 高性能 DHT Crawler 架構:佇列、背壓與資源邊界
- 每分鐘獲取 1,000+ 條 Torrent Metadata,需要甚麼樣的架構?
參考資料
下一篇: 高性能 DHT Crawler 架構:佇列、背壓與資源邊界 →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。