
BT9G LABS / DHT 深度解析 #20
BT9G 如何規模化索引 BitTorrent Metadata:參考 DHT 架構
一套面向 BT9G Labs 的參考架構,把 DHT discovery、持久化 InfoHash 狀態、Metadata acquisition、搜索索引和可觀測性連接起來。
BT9G Labs / DHT Deep Dive #20. 把前 19 篇中的協議與工程原則組合成一套可擴展參考架構,說明 BT9G 一類搜索系統應該如何拆層。
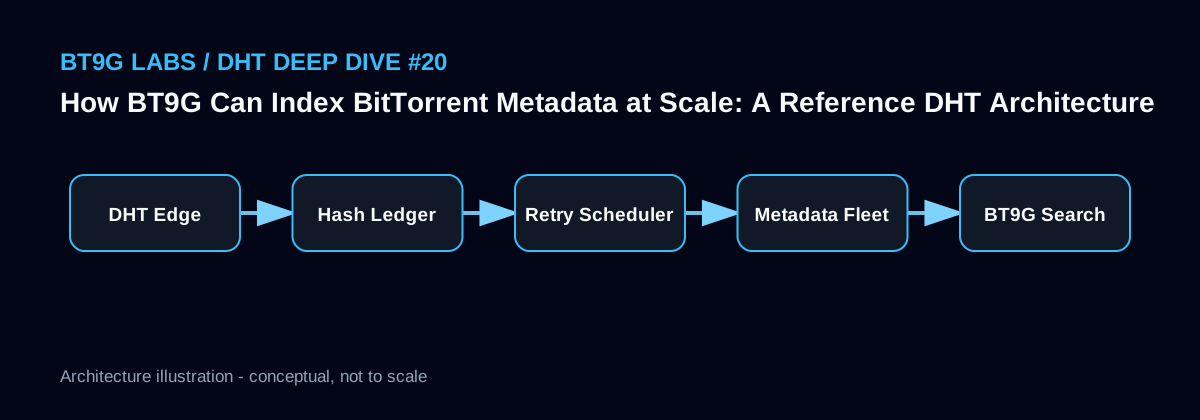
快速摘要
- 主題: BT9G 如何規模化索引 BitTorrent Metadata:參考 DHT 架構
- 核心關鍵詞: BT9G, DHT 架構, Metadata indexing, BitTorrent search, 分布式 crawler
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
系統視圖
第一層:Discovery Edge
最外層是一組長期在線的 DHT nodes/crawlers,負責參與公共 DHT、維護 routing table、處理 KRPC,並把觀察到的 InfoHash 與 Peer activity 變成輕量事件。這個層的職責是高吞吐量、低延遲和協議正確,而不是同步完成 Metadata。
多個區域的 discovery worker 可以提高網路視角多樣性,但需要共享去重和 ownership 規則,避免只是重複製造相同任務。
第二層:Hash Ledger
所有內容身份進入持久化 hash ledger。它負責 exact dedup、first_seen/last_seen、狀態機、失敗類型、next_retry、活動計數和 Metadata identity 關係。這個 ledger 才是長期積累的核心資產。
Peer endpoints 不應該與內容身份同壽命保存;它們更適合進入帶 TTL 的短期 candidate store,並記錄最近來源與可連接質量。
第三層:Metadata Acquisition Fleet
調度器根據活動度、歷史失敗和資源預算挑選需要嘗試的 InfoHash,worker 從 DHT/Tracker/歷史資料獲取 Peer candidates,建立連接並通過 BEP 10/BEP 9 拉取 Metadata。所有完成資料必須經過身份校驗後才能升級為 canonical metadata。
worker 數量可以獨立擴縮容,timeout 與併發應圍繞成功率、p95 latency 和主機資源動態調整。
第四層:Serving、Ranking 與 Observability
經過驗證的內容進入 canonical store,並派生到 Elasticsearch 等搜索層。查詢服務只讀取面向使用者的穩定欄位和經過解釋的活動信號。排名可以結合文本相關性、新鮮度、最近網路活動和資料質量。
整個系統還需要統一 observability:從 UDP queries、unique hashes、Peer connection、BEP support、Metadata success 到 indexing lag 都應可追蹤。只有這樣,BT9G 才能知道新增資源速度究竟受哪一層限制。
實現示意
DHT observers
    |
    v
Hash event bus ---> metrics
    |
    v
Exact hash ledger <---- fresh activity wakes cold hashes
    |
    v
Retry / priority scheduler
    |
    v
Metadata fleet -> hash validation -> canonical metadata DB
                                   |
                                   v
                              enrichment
                                   |
                                   v
                              search index
                                   |
                                   v
                                BT9G
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 讓 discovery worker 同時承擔所有 Metadata 和索引職責。
- 把易失 Peer endpoints 當成和 InfoHash 一樣的永久實體。
- 未驗證 Metadata 就進入搜索 serving 層。
- 只有總吞吐量指標,沒有每個階段的成功率和延遲指標。
相關 BT9G Labs 文章
參考資料
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 11 - Peer Exchange (PEX)
- BEP 48 - Tracker Protocol Extension: Scrape
- BEP 52 - The BitTorrent Protocol Specification v2
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。