
BT9G LABS / DHT chuyên sâu #18
Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn
Thiết kế retry scheduler lưu các hash thất bại, dùng backoff theo failure class, nhận reactivation signal và giữ queue bền vững.
BT9G Labs / DHT Deep Dive #18. Swarm P2P thay đổi theo thời gian; thất bại hôm nay không đủ để kết luận metadata sẽ không bao giờ khả dụng.
Tóm tắt nhanh
- Chủ đề: Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn
- Từ khóa chính: InfoHash retry, retry scheduler, exponential backoff, reactivation signal, DHT metadata
- Đối tượng đọc: kỹ sư backend, người nghiên cứu giao thức, search engineer và nhà phát triển BitTorrent
- Mục tiêu: Giải thích giao thức và thiết kế hệ thống đủ chính xác để áp dụng vào pipeline discovery, metadata, indexing và search trong thực tế.
Góc nhìn hệ thống
Failure timestamp không phải tombstone
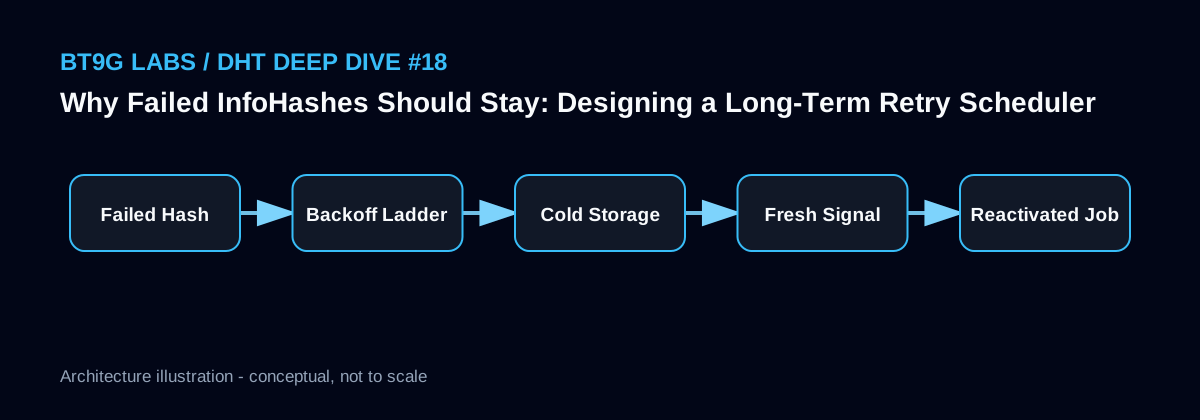
Peer có thể offline đúng lúc crawler thử rồi quay lại vài ngày sau. Tracker có thể phục hồi, DHT có thể tìm endpoint mới hoặc user mới làm Swarm cũ hoạt động trở lại. Xóa hash sau failure sẽ bỏ mất cơ hội đó.
Nên giữ identity và attempt history gọn. Trạng thái 'dormant' hoặc 'retry later' hợp lý hơn 'dead forever'.
Backoff nên phản ánh loại lỗi
Connect timeout, no peers, extension unsupported, reject và hash mismatch có tính chất khác nhau. No peers có thể retry sau interval trung bình, trong khi mismatch lặp lại từ nhiều nguồn nên dùng interval dài hơn.
Thêm jitter để hàng triệu job không thức dậy cùng lúc và giới hạn retry budget để job mới vẫn có capacity.
Fresh activity nên vượt qua bi quan cũ
Nếu hash dormant lại xuất hiện nhiều lần trong DHT hoặc có source mới cung cấp Peer fresh, scheduler nên tăng priority và kéo next_retry_at về sớm. Đây là event-driven reactivation.
Backoff giảm lãng phí khi im lặng; fresh signal giúp hệ thống phản ứng nhanh khi xác suất thành công tăng.
Retry queue phải durable
Không nên giữ lịch chỉ trong memory. Restart không được làm mất hàng triệu retry state hoặc khiến toàn bộ job chạy lại từ đầu. Dùng database, durable queue hoặc time-indexed structure có thể reconstruct.
Worker nên dùng lease/idempotency để tránh nhiều instance lấy cùng hash một cách vô ích.
Phác thảo triển khai
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
Ghi chú kỹ thuật từ BT9G Labs
Với một hệ thống lập chỉ mục như BT9G, số lượng packet hoặc InfoHash nhìn thấy không phải là thước đo quan trọng duy nhất. Nên tách rõ danh tính nội dung, quan sát mạng, trạng thái thu thập, metadata đã xác minh và search document thành các lớp dữ liệu riêng. Mọi dữ liệu đến từ DHT hoặc Peer nên có nguồn và timestamp. Khi đó có thể theo dõi bottleneck ở từng giai đoạn: discovery, kết nối, handshake, extension negotiation, metadata transfer, verification, lưu trữ và indexing.
Sai lầm thường gặp
- Xóa hash sau một failure.
- Dùng cùng backoff cho mọi error class.
- Không thêm jitter cho lịch retry lớn.
- Giữ retry state chỉ trong process memory.
Bài viết BT9G Labs liên quan
- Cần Gì Để Lấy Hơn 1.000 Torrent Metadata Mỗi Phút
- Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata
- Xây Dựng BitTorrent Search Index: Từ DHT Đến Metadata Và Elasticsearch
- BT9G Có Thể Index BitTorrent Metadata Ở Quy Mô Lớn Như Thế Nào: Kiến Trúc DHT Tham Chiếu
Tài liệu tham khảo
Bài tiếp theo: Xây Dựng BitTorrent Search Index: Từ DHT Đến Metadata Và Elasticsearch →
Bài viết này nhằm giải thích các giao thức BitTorrent công khai và mô hình kỹ thuật. Việc quan sát một Swarm không đồng nghĩa nội dung đó đang khả dụng, hợp lệ hoặc được phép phân phối.