BT9G LABS / DHT chuyên sâu #19
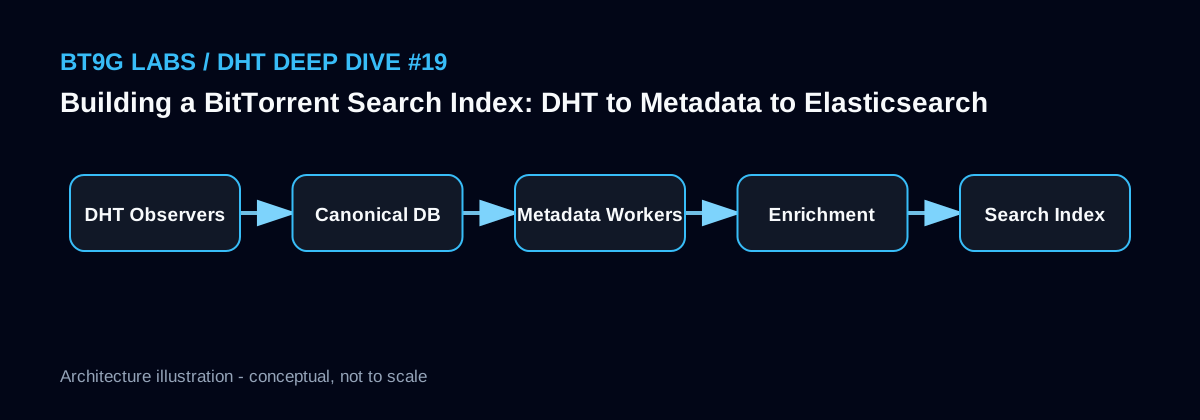
Xây Dựng BitTorrent Search Index: Từ DHT Đến Metadata Và Elasticsearch
Kiến trúc pipeline tách discovery, metadata validation, canonical storage, enrichment và Elasticsearch để indexing an toàn và có thể rebuild.
BT9G Labs / DHT Deep Dive #19. Search index nên là dữ liệu dẫn xuất từ metadata đã xác minh, không phải nơi đầu tiên nhận dữ liệu thô từ DHT.
Tóm tắt nhanh
- Chủ đề: Xây Dựng BitTorrent Search Index: Từ DHT Đến Metadata Và Elasticsearch
- Từ khóa chính: BitTorrent search engine, DHT, metadata pipeline, Elasticsearch, search indexing
- Đối tượng đọc: kỹ sư backend, người nghiên cứu giao thức, search engineer và nhà phát triển BitTorrent
- Mục tiêu: Giải thích giao thức và thiết kế hệ thống đủ chính xác để áp dụng vào pipeline discovery, metadata, indexing và search trong thực tế.
Góc nhìn hệ thống
Search index nằm sau validation
Discovery event và metadata từ Peer chưa đủ tin cậy để đưa thẳng vào Elasticsearch. Pipeline lý tưởng cần dedup identity, lấy metadata, hash verification, parsing và canonical persistence trước. Chỉ record hợp lệ mới được biến thành search document.
Ranh giới này cho phép xóa và rebuild index mà không mất source of truth.
Canonical storage và derived search storage
Canonical database lưu identity, metadata đã verify, file list, size, hash version và lifecycle state. Elasticsearch lưu dạng tối ưu cho full-text, filter, aggregation, autocomplete và ranking.
Không nên dùng Elasticsearch làm nơi duy nhất giữ raw metadata vì mapping và analyzer có thể thay đổi.
Enrichment mà không làm hỏng identity
Language detection, tokenization, category, tag, normalized title và media hint có thể thêm ở bước enrichment. Đây là dữ liệu dẫn xuất và có thể tính lại khi rule/model thay đổi.
Không được sửa bytes dùng để verify InfoHash. Protocol identity phải immutable.
Ranking signal
Ranking có thể kết hợp text relevance, metadata freshness, last_seen, recent activity, file completeness, source diversity và document quality. Mỗi signal cần normalize để một crawler hoặc một nguồn event không áp đảo kết quả.
Tách feature khỏi canonical data giúp thử nghiệm ranking dễ hơn.
Phác thảo triển khai
{
  "infohash": "...",
  "title": "Example Release",
  "total_size": 734003200,
  "file_count": 12,
  "extensions": ["mkv", "srt"],
  "first_seen": "...",
  "last_seen": "...",
  "metadata_verified": true,
  "activity_score": 0.73
}
Ghi chú kỹ thuật từ BT9G Labs
Với một hệ thống lập chỉ mục như BT9G, số lượng packet hoặc InfoHash nhìn thấy không phải là thước đo quan trọng duy nhất. Nên tách rõ danh tính nội dung, quan sát mạng, trạng thái thu thập, metadata đã xác minh và search document thành các lớp dữ liệu riêng. Mọi dữ liệu đến từ DHT hoặc Peer nên có nguồn và timestamp. Khi đó có thể theo dõi bottleneck ở từng giai đoạn: discovery, kết nối, handshake, extension negotiation, metadata transfer, verification, lưu trữ và indexing.
Sai lầm thường gặp
- Index metadata trước hash verification.
- Dùng Elasticsearch làm source of truth duy nhất.
- Làm thay đổi identity data trong enrichment.
- Để một activity metric thô chi phối ranking.
Bài viết BT9G Labs liên quan
- Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata
- Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn
- BT9G Có Thể Index BitTorrent Metadata Ở Quy Mô Lớn Như Thế Nào: Kiến Trúc DHT Tham Chiếu
Tài liệu tham khảo
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 48 - Tracker Protocol Extension: Scrape
Bài viết này nhằm giải thích các giao thức BitTorrent công khai và mô hình kỹ thuật. Việc quan sát một Swarm không đồng nghĩa nội dung đó đang khả dụng, hợp lệ hoặc được phép phân phối.