BT9G LABS / DHT chuyên sâu #16
Cần Gì Để Lấy Hơn 1.000 Torrent Metadata Mỗi Phút
Mô hình capacity cho 1.000+ metadata thành công mỗi phút: concurrency, latency, success rate, Peer discovery, host limits và scale-out.
BT9G Labs / DHT Deep Dive #16. Mục tiêu throughput nên đo bằng metadata đã verify thành công mỗi phút, không phải số request đã gửi.
Tóm tắt nhanh
- Chủ đề: Cần Gì Để Lấy Hơn 1.000 Torrent Metadata Mỗi Phút
- Từ khóa chính: 1000 metadata per minute, Torrent metadata throughput, concurrency, Little's Law, DHT architecture
- Đối tượng đọc: kỹ sư backend, người nghiên cứu giao thức, search engineer và nhà phát triển BitTorrent
- Mục tiêu: Giải thích giao thức và thiết kế hệ thống đủ chính xác để áp dụng vào pipeline discovery, metadata, indexing và search trong thực tế.
Góc nhìn hệ thống
Bắt đầu từ success throughput
Một nghìn metadata mỗi phút tương đương khoảng 16,7 metadata verified mỗi giây. Nếu chỉ 20% attempt thành công, hệ thống có thể cần hơn 80 attempt mỗi giây trước khi tính retry và timeout. Vì vậy request rate không phải output rate.
Hãy định nghĩa success là metadata đầy đủ, hash verification pass và được lưu thành công.
Little's Law cho ước lượng đầu tiên
Nếu mỗi attempt giữ một slot trong vài giây, concurrency cần thiết xấp xỉ arrival rate nhân với thời gian trung bình trong hệ thống. Ví dụ 80 attempt/s và 4 giây average có thể cần hàng trăm slot đồng thời.
Tail latency và timeout dài có thể giữ slot quá lâu, vì vậy deadline và alternate Peer scheduling rất quan trọng.
Peer discovery có thể là bottleneck ẩn
Metadata worker không thể chạy nếu thiếu endpoint Peer chất lượng. DHT lookup, Tracker, PEX và candidate cache phải cung cấp đủ Peer fresh.
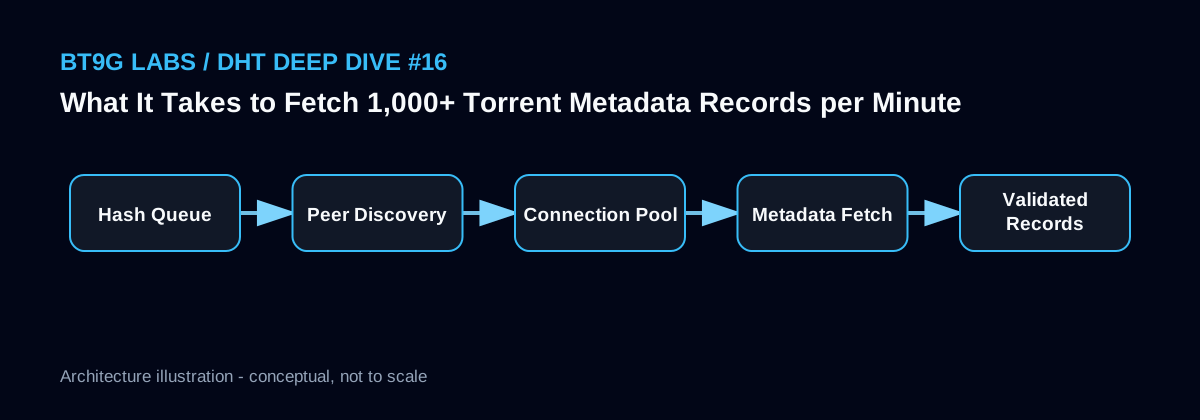
Nên đo funnel riêng: hashes ready, peers discovered, connect success, ut_metadata supported và metadata verified.
Host limit vẫn quyết định
File descriptor, ephemeral port, NAT table, kernel buffer, TCP backlog, bandwidth và memory đều có thể giới hạn một host. Kernel tuning giúp một phần, nhưng khi một máy đạt diminishing return thì scale-out thường ổn định hơn.
Dùng nhiều fetcher với shared queue và idempotency để tăng capacity tuyến tính hơn.
Phác thảo triển khai
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
Ghi chú kỹ thuật từ BT9G Labs
Với một hệ thống lập chỉ mục như BT9G, số lượng packet hoặc InfoHash nhìn thấy không phải là thước đo quan trọng duy nhất. Nên tách rõ danh tính nội dung, quan sát mạng, trạng thái thu thập, metadata đã xác minh và search document thành các lớp dữ liệu riêng. Mọi dữ liệu đến từ DHT hoặc Peer nên có nguồn và timestamp. Khi đó có thể theo dõi bottleneck ở từng giai đoạn: discovery, kết nối, handshake, extension negotiation, metadata transfer, verification, lưu trữ và indexing.
Sai lầm thường gặp
- Đo request rate thay cho metadata throughput.
- Giả định success rate 100%.
- Bỏ qua Peer discovery trong capacity planning.
- Tăng concurrency trước khi kiểm tra file descriptor, port và timeout.
Bài viết BT9G Labs liên quan
- Vì Sao Lấy Torrent Metadata Thất Bại: 10 Nguyên Nhân Thực Tế Và Mô Hình Retry Tốt Hơn
- Thiết Kế DHT Crawler Hiệu Năng Cao: Kiến Trúc, Queue Và Backpressure
- Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata
- Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn
Tài liệu tham khảo
Bài tiếp theo: Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata →
Bài viết này nhằm giải thích các giao thức BitTorrent công khai và mô hình kỹ thuật. Việc quan sát một Swarm không đồng nghĩa nội dung đó đang khả dụng, hợp lệ hoặc được phép phân phối.