
BT9G LABS / DHT chuyên sâu #17
Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata
Thiết kế dedup ở quy mô lớn với hot cache, Bloom filter, durable ledger, scheduling state và partitioning.
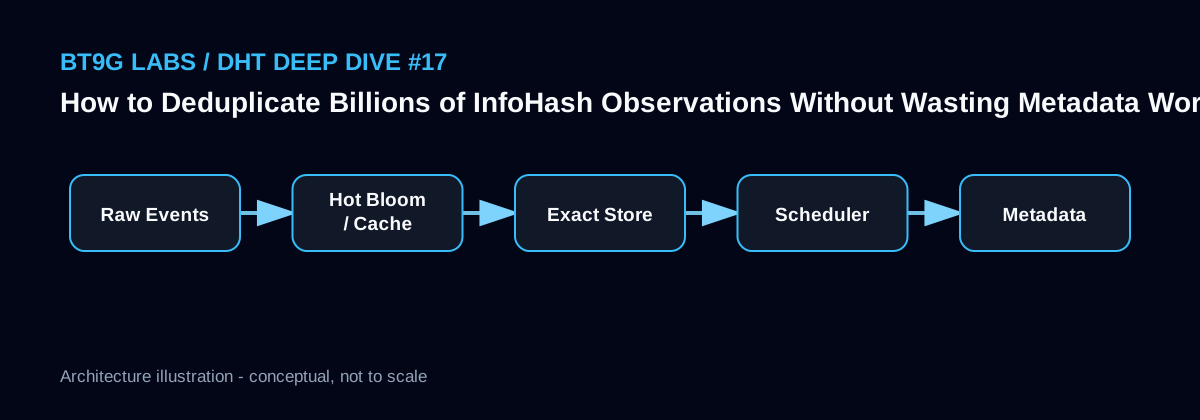
BT9G Labs / DHT Deep Dive #17. Deduplication là subsystem cốt lõi quyết định crawler xử lý content mới hay tiếp tục lặp lại cùng một công việc.
Tóm tắt nhanh
- Chủ đề: Cách Deduplicate Hàng Tỷ Observation InfoHash Mà Không Lãng Phí Công Việc Metadata
- Từ khóa chính: InfoHash deduplication, Bloom filter, Redis, hash ledger, large-scale crawler
- Đối tượng đọc: kỹ sư backend, người nghiên cứu giao thức, search engineer và nhà phát triển BitTorrent
- Mục tiêu: Giải thích giao thức và thiết kế hệ thống đủ chính xác để áp dụng vào pipeline discovery, metadata, indexing và search trong thực tế.
Góc nhìn hệ thống
Deduplication là subsystem hạng nhất
Cùng một InfoHash có thể xuất hiện nhiều lần từ node, thời điểm và collector khác nhau. Hệ thống nên gộp các event về một identity canonical nhưng vẫn giữ thống kê như first_seen, last_seen, source_count và activity_count.
Nếu mỗi event tạo job metadata mới, workload sẽ tăng theo traffic thay vì số nội dung unique.
Probabilistic filter ở phía trước, không phải source of truth
Bloom filter rất tiết kiệm bộ nhớ để trả lời 'có thể đã thấy', nhưng có false positive. Nó phù hợp để giảm database lookup, không phù hợp để quyết định vĩnh viễn rằng một hash không cần lưu.
Redis cache cũng hữu ích cho hot window, còn durable database giữ record canonical.
Tách existence khỏi scheduling state
Câu hỏi 'hash này từng tồn tại chưa?' khác với 'có cần fetch metadata ngay không?'. Identity record có thể tồn tại lâu dài, còn scheduler state chuyển qua new, queued, fetching, verified, retry hoặc dormant.
Cách tách này cho phép hash cũ được kích hoạt lại mà không tạo duplicate identity.
Partition cho tăng trưởng dài hạn
Sharding theo hash prefix cung cấp ownership deterministic. Storage cũng có thể tách hash ledger, event aggregate, canonical metadata và search index để tối ưu theo workload.
Không nên lưu mọi raw event vĩnh viễn. Time-bucket aggregation hoặc compaction giúp giữ tín hiệu hữu ích với chi phí thấp hơn.
Phác thảo triển khai
CREATE TABLE infohash_state (
  hash VARBINARY(32) NOT NULL,
  hash_type TINYINT NOT NULL,
  first_seen DATETIME NOT NULL,
  last_seen DATETIME NOT NULL,
  seen_count BIGINT NOT NULL,
  metadata_status TINYINT NOT NULL,
  next_retry DATETIME NULL,
  PRIMARY KEY(hash_type, hash)
);
Ghi chú kỹ thuật từ BT9G Labs
Với một hệ thống lập chỉ mục như BT9G, số lượng packet hoặc InfoHash nhìn thấy không phải là thước đo quan trọng duy nhất. Nên tách rõ danh tính nội dung, quan sát mạng, trạng thái thu thập, metadata đã xác minh và search document thành các lớp dữ liệu riêng. Mọi dữ liệu đến từ DHT hoặc Peer nên có nguồn và timestamp. Khi đó có thể theo dõi bottleneck ở từng giai đoạn: discovery, kết nối, handshake, extension negotiation, metadata transfer, verification, lưu trữ và indexing.
Sai lầm thường gặp
- Tạo metadata job cho mọi observation trùng.
- Dùng Bloom filter làm source of truth duy nhất.
- Trộn identity state với scheduler state.
- Lưu raw event vô hạn mà không có retention.
Bài viết BT9G Labs liên quan
- Thiết Kế DHT Crawler Hiệu Năng Cao: Kiến Trúc, Queue Và Backpressure
- Cần Gì Để Lấy Hơn 1.000 Torrent Metadata Mỗi Phút
- Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn
- Xây Dựng BitTorrent Search Index: Từ DHT Đến Metadata Và Elasticsearch
Tài liệu tham khảo
Bài tiếp theo: Vì Sao InfoHash Thất Bại Vẫn Nên Được Giữ: Thiết Kế Retry Scheduler Dài Hạn →
Bài viết này nhằm giải thích các giao thức BitTorrent công khai và mô hình kỹ thuật. Việc quan sát một Swarm không đồng nghĩa nội dung đó đang khả dụng, hợp lệ hoặc được phép phân phối.