BT9G LABS / เจาะลึก DHT #06
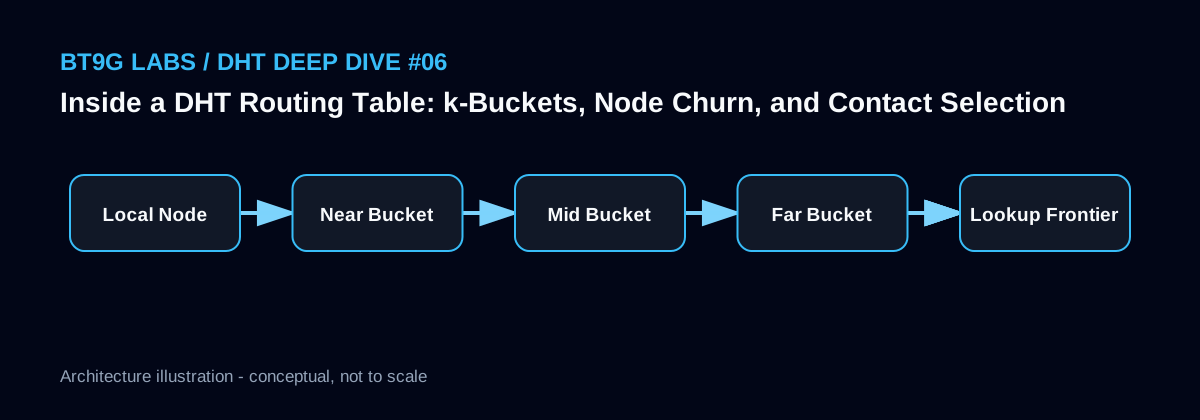
ภายใน Routing Table ของ DHT: k-Bucket, Node Churn และการเลือก Contact
ทำความเข้าใจว่า k-bucket แบ่งพื้นที่ XOR อย่างไร เหตุใด node ที่เสถียรจึงมีค่า และ routing table ถูกดูแลอย่างไรในเครือข่ายที่มี churn สูง
BT9G Labs / DHT Deep Dive #06. Routing table ของ DHT ไม่ใช่รายชื่อทั้งเครือข่าย แต่เป็น cache แบบมีโครงสร้างที่มากพอสำหรับเข้าถึงส่วนอื่นของ ID space
สรุปแบบรวดเร็ว
- หัวข้อ: ภายใน Routing Table ของ DHT: k-Bucket, Node Churn และการเลือก Contact
- คีย์เวิร์ดหลัก: k-bucket, DHT routing table, node churn, Kademlia, contact selection
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
ใช้ distance band แทน list ขนาดยักษ์
Kademlia จัด contact ตามช่วง XOR distance แต่ละ k-bucket เก็บ node ได้จำกัด ทำให้ routing table ครอบคลุม target ใกล้และไกลโดยไม่โตตามจำนวน node ทั้งเครือข่าย
การมี contact แบบสุ่มหลายพันตัวใน list เดียวไม่ได้ให้โครงสร้างแบบเดียวกัน และทำให้การเลือก candidate แพงขึ้น
เหตุใด node เก่าที่ตอบสนองจึงมีค่า
เครือข่าย P2P มี churn ตลอดเวลา Node ที่ตอบสนองได้ต่อเนื่องเป็นเวลานานมีหลักฐานด้านเสถียรภาพมากกว่า contact ใหม่ที่เห็นครั้งเดียว Kademlia แบบคลาสสิกจึงมักเก็บ node เก่าไว้หากยังมีชีวิต
Crawler สามารถเพิ่มข้อมูล last_seen, RTT และ success rate เพื่อช่วยตัดสินใจ แต่ไม่ควรทำลายความหลากหลายของ distance band
การ refresh และ split
Bucket ที่ไม่ได้ใช้นานควรถูก refresh ด้วย lookup ไปยัง target ในช่วงของ bucket นั้น Implementation บางแบบจะแยก bucket เมื่อเต็มตามกฎ Kademlia เป้าหมายคือรักษาความสดของ routing knowledge ไม่ใช่สร้าง traffic ให้มากที่สุด
ควรใช้ jitter และ rate limit เพื่อไม่ให้ bucket จำนวนมาก refresh พร้อมกันหลัง restart
Routing table เป็น cache ไม่ใช่ความจริงทั้งหมด
Node ID และ endpoint สามารถ stale ได้จาก NAT, IP เปลี่ยน, client restart หรือ node ID เปลี่ยน ทุก entry จึงควรมี liveness state และ timestamp
ไม่ควรใช้ routing table เป็นตัวแทนตรง ๆ ของจำนวนผู้ใช้หรือจำนวน node ทั้งหมดใน DHT เพราะข้อมูลถูก bias จากตำแหน่งและ pattern ของ crawler เอง
ตัวอย่างการนำไปใช้
type Contact struct {
    ID        [20]byte
    IP        net.IP
    Port      uint16
    LastSeen  time.Time
    Failures  uint8
    RTT       time.Duration
}
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- คิดว่า routing table คือ snapshot ทั้ง DHT
- ไม่เก็บ last_seen หรือ liveness state
- แทนที่ node เสถียรด้วย contact ใหม่ทุกครั้ง
- refresh ทุก bucket พร้อมกันโดยไม่มี rate limit
บทความ BT9G Labs ที่เกี่ยวข้อง
- เจาะลึก InfoHash: BitTorrent v1, v2, Magnet Link, BTIH และ BTMH
- อธิบายข้อความ DHT ใน BEP 5: ping, find_node, get_peers และ announce_peer
- ทำไม DHT จึงเห็น InfoHash จำนวนมาก? ทำความเข้าใจ Swarm Discovery ในระดับ Internet
- DHT Crawler ค้นพบ InfoHash อย่างไร: Active Lookup, Observation และการออกแบบอย่างรับผิดชอบ
เอกสารอ้างอิง
บทความถัดไป: ทำไม DHT จึงเห็น InfoHash จำนวนมาก? ทำความเข้าใจ Swarm Discovery ในระดับ Internet →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่