
BT9G LABS / เจาะลึก DHT #07
ทำไม DHT จึงเห็น InfoHash จำนวนมาก? ทำความเข้าใจ Swarm Discovery ในระดับ Internet
เรียนรู้ว่า activity แบบกระจายสร้าง InfoHash observation จำนวนมหาศาลอย่างไร และเหตุใด deduplication กับ ranking จึงสำคัญ
BT9G Labs / DHT Deep Dive #07. จำนวน InfoHash ใน DHT เกิดจาก activity ที่ซ้ำและกระจาย ไม่ได้มาจาก registry กลางที่ปล่อยรายชื่อ Torrent ใหม่
สรุปแบบรวดเร็ว
- หัวข้อ: ทำไม DHT จึงเห็น InfoHash จำนวนมาก? ทำความเข้าใจ Swarm Discovery ในระดับ Internet
- คีย์เวิร์ดหลัก: InfoHash discovery, DHT scale, Swarm activity, deduplication, BitTorrent
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
InfoHash เกิดจาก activity ไม่ใช่ registry
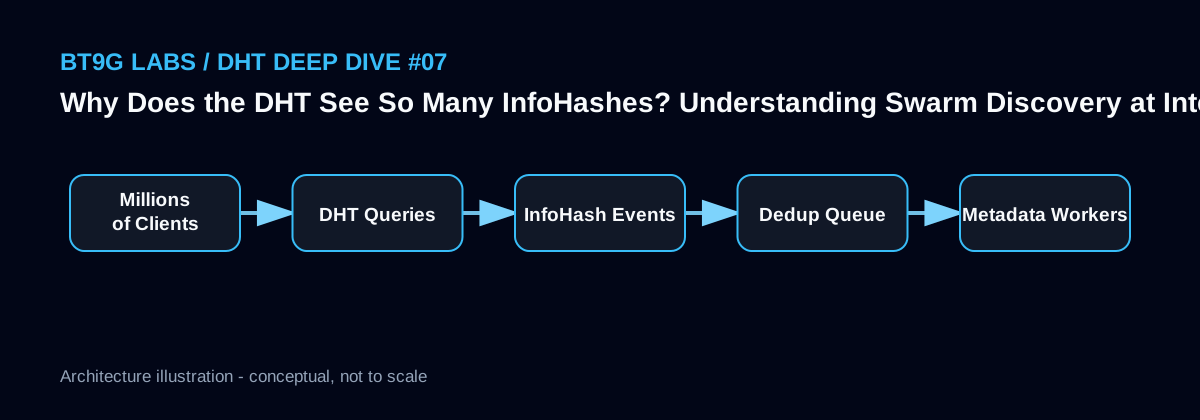
DHT ไม่มี feed ทางการของ 'Torrent ใหม่' InfoHash จะปรากฏเมื่อ client ค้นหา Peer, announce participation หรือเมื่อ lookup ที่เกี่ยวข้องผ่าน node ใด node หนึ่ง Swarm ที่ active สามารถสร้าง observation ซ้ำจำนวนมากจากหลายเวลาและหลายตำแหน่ง
ดังนั้นจำนวน event ดิบจึงมากกว่าจำนวน identity แบบ unique อย่างมาก Ingestion pipeline ควรถือ event เป็น activity signal และถือ InfoHash เป็น identity ที่ต้อง dedup
ทำไม stream จึงมี noise
ไม่ใช่ทุก target จะนำไปสู่ metadata บาง hash มาจาก Swarm ที่เงียบแล้ว, input สุ่ม, experiment, scanning หรือ Peer ที่หายไปอย่างรวดเร็ว Endpoint อาจ stale ก่อน worker จะเชื่อมต่อ
การทิ้งทุก hash ที่ล้มเหลวครั้งแรกจะพลาด content ที่อาจกลับมา active แต่การ retry ทุกอย่างถี่ ๆ ก็สิ้นเปลือง จึงต้องใช้ scheduler ที่มี evidence และ backoff
Deduplication เปลี่ยนต้นทุนของระบบ
หาก InfoHash เดียวถูกพบหลายร้อยครั้ง ไม่ควร fetch metadata หลายร้อยครั้ง Hot-path dedup สามารถรวม observation เข้า record เดียว อัปเดต last_seen และ activity count แล้ว enqueue เฉพาะเมื่อ acquisition state ต้องการ
Bloom filter หรือ Redis ช่วยลด duplicate แบบร้อนได้ แต่ durable database ยังควรเป็น source of truth
Activity เป็น ranking signal ไม่ใช่ popularity แบบสมบูรณ์
ความถี่ของ observation ช่วยบอกว่า Swarm อาจ active แต่ตัวเลขนี้ถูก bias จากตำแหน่ง crawler, เวลา, topology และ implementation จึงไม่ใช่จำนวนผู้ใช้ทั่วโลก
ควรใช้ activity ร่วมกับ freshness, connect success, source diversity และ metadata quality พร้อมแสดง label ใน UI อย่างซื่อสัตย์ เช่น 'recently observed'
ตัวอย่างการนำไปใช้
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- คิดว่าจำนวน DHT event เท่ากับจำนวน Torrent unique
- คิดว่า InfoHash ทุกตัวต้องดึง metadata ได้
- fetch metadata ใหม่ทุกครั้งที่พบ hash ซ้ำ
- แสดง activity count เป็นจำนวนผู้ใช้ทั่วโลกแบบแม่นยำ
บทความ BT9G Labs ที่เกี่ยวข้อง
- อธิบายข้อความ DHT ใน BEP 5: ping, find_node, get_peers และ announce_peer
- ภายใน Routing Table ของ DHT: k-Bucket, Node Churn และการเลือก Contact
- DHT Crawler ค้นพบ InfoHash อย่างไร: Active Lookup, Observation และการออกแบบอย่างรับผิดชอบ
- จาก Magnet Link ไปสู่ File Metadata: Flow ของ Peer และ Metadata แบบครบถ้วน
เอกสารอ้างอิง
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่