
BT9G LABS / เจาะลึก DHT #08
DHT Crawler ค้นพบ InfoHash อย่างไร: Active Lookup, Observation และการออกแบบอย่างรับผิดชอบ
ทำความเข้าใจกลยุทธ์ discovery ของ InfoHash การแยก discovery ออกจาก metadata acquisition และการออกแบบ ingestion path ที่มีประสิทธิภาพ
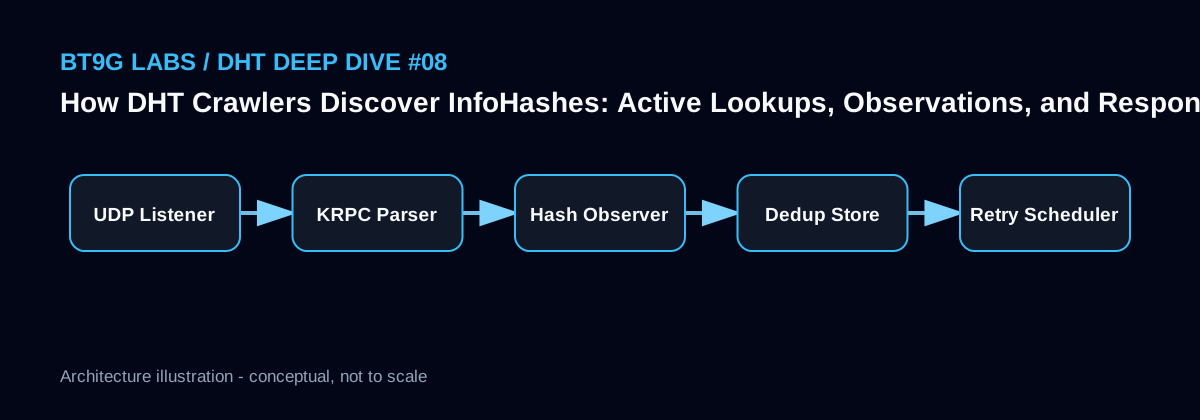
BT9G Labs / DHT Deep Dive #08. Crawler ที่ดีจะแยกกระแส observation ของ DHT ที่เร็วออกจากงาน metadata ที่ช้ากว่าและใช้ resource มากกว่า
สรุปแบบรวดเร็ว
- หัวข้อ: DHT Crawler ค้นพบ InfoHash อย่างไร: Active Lookup, Observation และการออกแบบอย่างรับผิดชอบ
- คีย์เวิร์ดหลัก: DHT crawler, InfoHash discovery, active lookup, crawler architecture, BitTorrent
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
Discovery และ acquisition เป็นคนละ pipeline
การพบ InfoHash มีต้นทุนต่ำกว่าการดึง metadata สมบูรณ์มาก Discovery อาจแค่ parse packet และบันทึก identity ส่วน metadata ต้องหา Peer, เชื่อมต่อ, handshake, extension negotiation, transfer piece และ verify hash
หากทำทั้งหมดใน worker เดียว connection ที่ช้าสามารถอุดตัน UDP input ได้ สถาปัตยกรรมที่ดีกว่าคือเขียน hash ลง ledger/queue อย่างรวดเร็วแล้วส่ง acquisition ไปยัง worker pool แยก
กลยุทธ์ active และ observational
Crawler สามารถเรียนรู้เครือข่ายจาก lookup ที่ตนเป็นฝ่ายเริ่ม และจาก target ที่ปรากฏใน request ซึ่งวิ่งเข้ามา ทั้งสองแหล่งมี bias ต่างกัน Active lookup ถูกควบคุมโดย crawler ส่วน observation ขึ้นกับ traffic ที่มาถึง node นั้น
Collector หลายตัวใน network ต่างกันช่วยเพิ่ม coverage ได้ แต่ข้อมูลยังต้องเก็บ provenance และ dedup
Hot path ของ ingestion
เส้นทาง UDP ควรสั้น: parse, validate, normalize key, บันทึก source/time, dedup แบบเบา แล้ว enqueue Database I/O หนัก, enrichment และ metadata fetch ไม่ควร block packet loop
Queue ควร bounded เมื่อ downstream ช้าควรมี sampling หรือ policy ลด load ที่วัดผลได้ ดีกว่าปล่อย memory โตจน process ล่ม
พฤติกรรมต่อเครือข่ายอย่างรับผิดชอบ
Rate limit, timeout ที่เหมาะสม, packet ขนาดถูกต้อง และไม่ส่ง traffic ปลอมเป็นส่วนหนึ่งของ engineering ที่ดี Crawler ไม่จำเป็นต้อง spam query ซ้ำเพื่อเพิ่มตัวเลข discovery
หลีกเลี่ยง announce_peer หาก crawler ไม่ได้เป็น Peer จริงของ content นั้น
ตัวอย่างการนำไปใช้
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- fetch metadata ใน hot path ของ UDP
- คิดว่า collector ตัวเดียวเห็น DHT ทั้งหมด
- ใช้ queue แบบไร้ขีดจำกัด
- ส่ง query หรือ announce เกินจำเป็นเพื่อเพิ่ม volume
บทความ BT9G Labs ที่เกี่ยวข้อง
- ภายใน Routing Table ของ DHT: k-Bucket, Node Churn และการเลือก Contact
- ทำไม DHT จึงเห็น InfoHash จำนวนมาก? ทำความเข้าใจ Swarm Discovery ในระดับ Internet
- จาก Magnet Link ไปสู่ File Metadata: Flow ของ Peer และ Metadata แบบครบถ้วน
- อธิบาย BEP 9 ut_metadata: การดึง Torrent Metadata จาก Peer
เอกสารอ้างอิง
บทความถัดไป: จาก Magnet Link ไปสู่ File Metadata: Flow ของ Peer และ Metadata แบบครบถ้วน →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่