BT9G LABS / เจาะลึก DHT #02
อธิบาย Kademlia: XOR Distance, Routing และเหตุผลที่ BitTorrent DHT ขยายสเกลได้
ทำความเข้าใจ XOR distance, iterative lookup, parallelism และ k-bucket ซึ่งทำให้ Kademlia ค้นหาเป้าหมายได้อย่างมีประสิทธิภาพใน DHT ขนาดใหญ่
BT9G Labs / DHT Deep Dive #02. Kademlia ทำให้แต่ละ node ต้องรู้จักเพียงส่วนเล็ก ๆ ของเครือข่าย แต่ยังสามารถค้นหา target ได้อย่างมีประสิทธิภาพ
สรุปแบบรวดเร็ว
- หัวข้อ: อธิบาย Kademlia: XOR Distance, Routing และเหตุผลที่ BitTorrent DHT ขยายสเกลได้
- คีย์เวิร์ดหลัก: Kademlia, XOR distance, DHT routing, k-bucket, iterative lookup
- เหมาะสำหรับ: วิศวกร backend, นักวิจัยโปรโตคอล, search engineer และผู้พัฒนา BitTorrent
- เป้าหมาย: อธิบายโปรโตคอลและสถาปัตยกรรมระบบอย่างแม่นยำพอที่จะนำไปใช้กับ discovery, metadata, indexing และ search pipeline ในระบบจริงได้
มุมมองระบบ
ทำไม XOR distance จึงสำคัญ
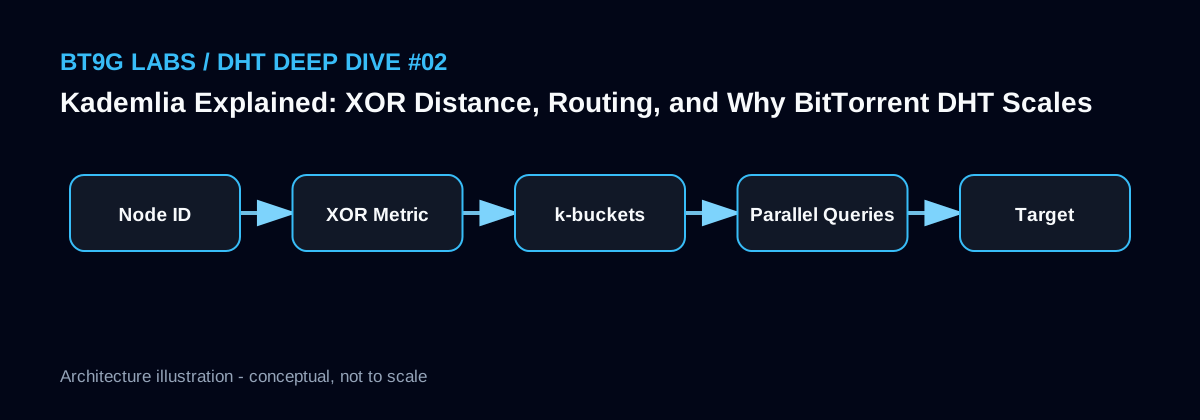
Kademlia วาง node ID และ target ไว้ใน keyspace เดียวกัน แล้วใช้ผล XOR เป็นระยะเชิงตรรกะ ระยะนี้มีคุณสมบัติที่เปรียบเทียบง่ายและสร้างลำดับที่ชัดเจนว่า node ใดใกล้ target มากกว่า Node จึงไม่ต้องรู้จักทั้งเครือข่าย แค่เลือก contact ที่มี XOR distance ลดลงเรื่อย ๆ ก็พอ
XOR distance ไม่ใช่ระยะทางทางภูมิศาสตร์หรือ network latency เซิร์ฟเวอร์คนละประเทศอาจใกล้กันมากใน ID space ขณะที่เครื่องใน data center เดียวกันอาจห่างกันมากในเชิงตรรกะ
ทำไม lookup จึงค่อย ๆ converge
Lookup จะเริ่มจาก contact ที่ใกล้ target ที่สุดใน routing table แล้วส่ง query แบบขนาน Response จะให้ candidate ใหม่ จากนั้น client เลือก node ที่ยังไม่เคย query และมี XOR distance ต่ำที่สุดต่อไป แต่ละรอบจึงลดระยะเข้าสู่ target จนไม่พบ node ที่ดีกว่า หรือได้ผลลัพธ์ที่ต้องการแล้ว
นี่คือเหตุผลที่ Kademlia ขยายสเกลได้โดยแต่ละ node ไม่ต้องมี global list ของทุก node ในระบบ
k-bucket จัด routing table อย่างไร
Routing table แบ่ง contact ตามช่วง XOR distance เป็น k-bucket แต่ละ bucket เก็บ node ได้จำนวนจำกัด ทำให้สามารถครอบคลุม keyspace กว้าง ๆ โดยใช้ memory จำกัด พื้นที่ใกล้ node เองอาจมีรายละเอียดมากกว่า ส่วนพื้นที่ไกลจะถูกแทนแบบหยาบกว่า
Node ที่ตอบสนองมานานมักมีค่ามากกว่า contact ใหม่ที่เพิ่งเห็นครั้งเดียว ในเครือข่ายที่มี churn สูง การเก็บ node ที่พิสูจน์แล้วว่ามีเสถียรภาพช่วยให้ routing table มีคุณภาพ
ผลต่อการออกแบบ crawler
Crawler ที่ดีควรมี routing knowledge ของตัวเอง จำกัด inflight query เก็บ contact คุณภาพดี และหลีกเลี่ยงการถาม node เดิมซ้ำสำหรับ target เดิม Scheduler สามารถแยก candidate, distance, visited state และผลลัพธ์ออกจากกันเพื่อควบคุมงานได้ชัดเจน
RTT และ failure rate ใช้ปรับ transport ได้ แต่ไม่ควรแทนที่ XOR distance ซึ่งเป็นกฎหลักของ routing ใน Kademlia
ตัวอย่างการนำไปใช้
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
บันทึกเชิงวิศวกรรมจาก BT9G Labs
สำหรับระบบทำดัชนีอย่าง BT9G ไม่ควรวัดความสำเร็จจากจำนวน packet หรือจำนวน InfoHash ที่มองเห็นเพียงอย่างเดียว ควรแยก content identity, network observation, acquisition state, verified metadata และ search document ออกจากกันเป็นชั้นข้อมูลที่ชัดเจน ข้อมูลจาก DHT หรือ Peer ควรเก็บ source และ timestamp เสมอ เพื่อให้วิเคราะห์ bottleneck ได้ตั้งแต่ discovery, connection, handshake, extension negotiation, metadata transfer, verification, storage ไปจนถึง indexing
ข้อผิดพลาดที่พบบ่อย
- ตีความ XOR distance ว่าเป็นระยะทางจริงบน Internet
- คิดว่าแต่ละ node ต้องรู้จักทุก node ใน DHT
- พยายามทำ routing table ให้ใหญ่ที่สุดโดยไม่สนใจคุณภาพ contact
- มองข้ามผลของ timeout และ parallelism ต่อความเร็วในการ converge
บทความ BT9G Labs ที่เกี่ยวข้อง
- DHT คืออะไร? คู่มือเชิงปฏิบัติของ Distributed Hash Table ใน BitTorrent
- BitTorrent DHT ค้นหา Peer อย่างไร: จาก Bootstrap ถึง get_peers และ announce_peer
- เจาะลึก InfoHash: BitTorrent v1, v2, Magnet Link, BTIH และ BTMH
เอกสารอ้างอิง
บทความถัดไป: BitTorrent DHT ค้นหา Peer อย่างไร: จาก Bootstrap ถึง get_peers และ announce_peer →
บทความนี้อธิบายโปรโตคอล BitTorrent แบบสาธารณะและแนวทางเชิงวิศวกรรม การสังเกตเห็น Swarm ใดไม่ได้หมายความว่าเนื้อหานั้นยังใช้งานได้ ถูกต้อง หรือได้รับอนุญาตให้เผยแพร่