BT9G LABS / DHT a fondo #06
Dentro de una DHT Routing Table: k-Bucket, Node Churn y selección de contactos
Cómo los k-bucket organizan contactos DHT, por qué importan los nodos estables y cómo se mantiene el routing bajo churn.
BT9G Labs / DHT Deep Dive #06. Una routing table no es un catálogo de toda la red, sino un cache limitado y continuamente actualizado de rutas probables.
Resumen rápido
- Tema: Dentro de una DHT Routing Table: k-Bucket, Node Churn y selección de contactos
- Palabras clave: k-bucket, DHT routing table, node churn, Kademlia, contact selection
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Rangos de distancia, no una lista infinita
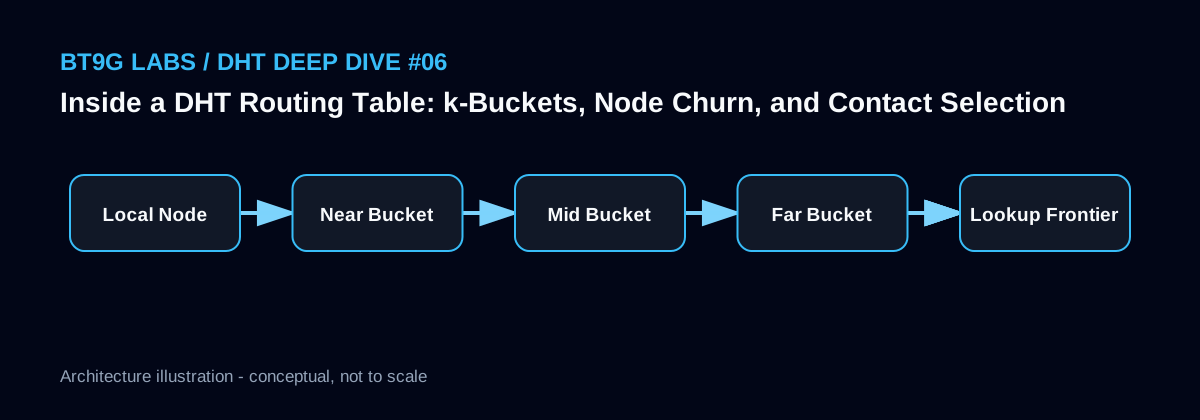
Kademlia divide la routing table en k-bucket que cubren rangos de distancia XOR. Cada bucket tiene capacidad limitada, lo que permite mantener alcance sobre todo el key space sin guardar millones de direcciones. Las regiones cercanas al propio Node ID pueden representarse con mayor detalle que las lejanas.
La estructura equilibra memoria limitada y capacidad de navegación global.
Por qué un nodo estable vale más
En P2P hay mucho churn: cambian IP, NAT mappings y disponibilidad. Un contacto antiguo que ha respondido varias veces suele tener más valor operativo que una dirección nueva observada una sola vez.
Métricas como last_seen, RTT y failure count pueden complementar la política, pero no conviene expulsar contactos estables por cualquier novedad.
Refresh, split y persistencia
Los bucket poco usados pueden refrescarse para recuperar cobertura. Algunas implementaciones dividen buckets cercanos al propio ID. Persistir la routing table acelera reinicios, pero los contactos restaurados deben volver a validarse.
La tabla representa contactos probablemente útiles ahora, no hechos permanentes sobre la red.
Esquema de implementación
type Contact struct {
    ID        [20]byte
    IP        net.IP
    Port      uint16
    LastSeen  time.Time
    Failures  uint8
    RTT       time.Duration
}
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Usar la routing table como base completa de todos los nodos DHT.
- Reemplazar siempre un nodo estable por uno nuevo.
- No refrescar buckets fríos.
- Confiar en contactos persistidos sin revalidación.
Artículos relacionados de BT9G Labs
- InfoHash a fondo: BitTorrent v1, v2, Magnet, BTIH y BTMH
- Mensajes DHT de BEP 5: ping, find_node, get_peers y announce_peer
- ¿Por qué DHT ve tantos InfoHash? Swarm Discovery a escala de Internet
- Cómo un DHT Crawler descubre InfoHash: Active Lookup, observación y diseño responsable
Referencias
Siguiente artículo: ¿Por qué DHT ve tantos InfoHash? Swarm Discovery a escala de Internet →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.