
BT9G LABS / DHT a fondo #08
Cómo un DHT Crawler descubre InfoHash: Active Lookup, observación y diseño responsable
Cómo separar discovery de InfoHash, Metadata acquisition e indexación en un crawler DHT escalable.
BT9G Labs / DHT Deep Dive #08. Separa el hot path UDP de las conexiones costosas a Peer y diseña crawling útil sin generar tráfico innecesario.
Resumen rápido
- Tema: Cómo un DHT Crawler descubre InfoHash: Active Lookup, observación y diseño responsable
- Palabras clave: DHT crawler, InfoHash discovery, active lookup, Metadata pipeline, BitTorrent
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
Discovery y acquisition son pipelines distintos
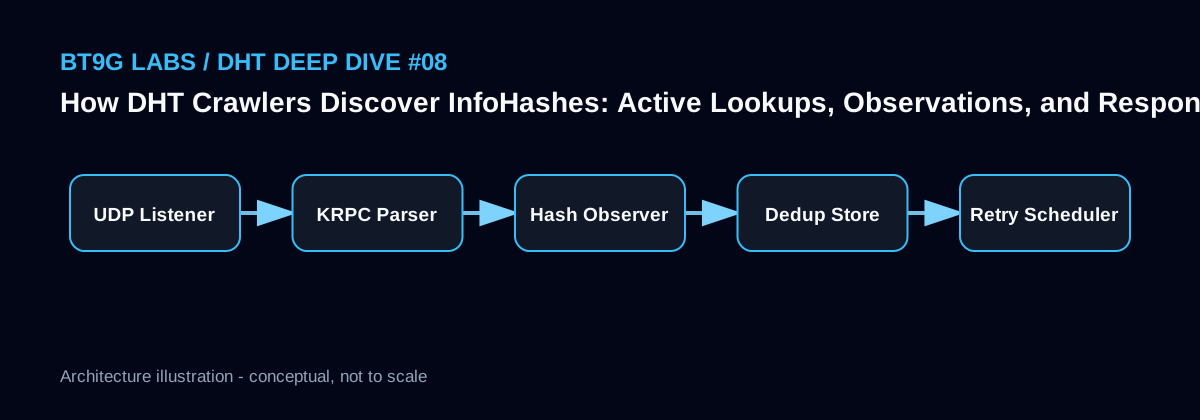
Observar un InfoHash es barato; buscar Peer, conectarse y descargar Metadata es mucho más costoso. El handler UDP debería validar, extraer pocos campos, deduplicar rápidamente y encolar en una bounded queue. Los Metadata workers trabajan de forma asíncrona.
Así un downstream lento no bloquea el packet plane.
Estrategias activas y observacionales
Un crawler puede lanzar find_node/get_peers para explorar activamente el key space y, al mismo tiempo, observar InfoHash presentes en queries recibidas de otros nodos. Cada estrategia tiene sesgos, por lo que conviene registrar discovery_source.
Ningún método único representa de forma completa toda la DHT de Internet.
Backpressure y comportamiento responsable
Si el ingreso supera al downstream, no hay que crecer la cola indefinidamente: se puede reducir el active crawl, fusionar duplicados y descartar observaciones repetidas de poco valor. También se debe limitar la frecuencia por nodo remoto y utilizar timeouts razonables.
La meta es maximizar información útil por request, no el número bruto de paquetes UDP.
Esquema de implementación
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Descargar Metadata de forma síncrona por cada hash observado.
- Hacer DB o I/O lento dentro del handler UDP.
- Afirmar que una estrategia cubre toda la DHT.
- Enviar consultas repetidas de alta frecuencia al mismo nodo.
Artículos relacionados de BT9G Labs
- Dentro de una DHT Routing Table: k-Bucket, Node Churn y selección de contactos
- ¿Por qué DHT ve tantos InfoHash? Swarm Discovery a escala de Internet
- De Magnet Link a Metadata: flujo completo de Peer Discovery y BEP 9/10
- BEP 9 ut_metadata explicado: obtener Torrent Metadata desde Peer
Referencias
Siguiente artículo: De Magnet Link a Metadata: flujo completo de Peer Discovery y BEP 9/10 →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.