
BT9G LABS / DHT a fondo #07
¿Por qué DHT ve tantos InfoHash? Swarm Discovery a escala de Internet
Por qué un observador DHT recibe un flujo enorme de InfoHash activos, repetidos, antiguos y de baja calidad.
BT9G Labs / DHT Deep Dive #07. Distingue entre volumen de eventos, hashes únicos y Metadata realmente recuperable.
Resumen rápido
- Tema: ¿Por qué DHT ve tantos InfoHash? Swarm Discovery a escala de Internet
- Palabras clave: DHT InfoHash, Swarm discovery, BitTorrent activity, deduplication, DHT crawler
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
Vista del sistema
No existe un registro central de InfoHash
DHT no contiene un catálogo global descargable de Torrents. Los InfoHash aparecen por queries, announces y exploración activa del espacio de claves. El conjunto que ve un crawler depende de su tiempo online, posición de routing, estrategia y red.
Por eso cualquier cifra de «nuevos hashes por día» debe atribuirse a una metodología concreta, no presentarse automáticamente como total mundial.
El flujo contiene mucho ruido
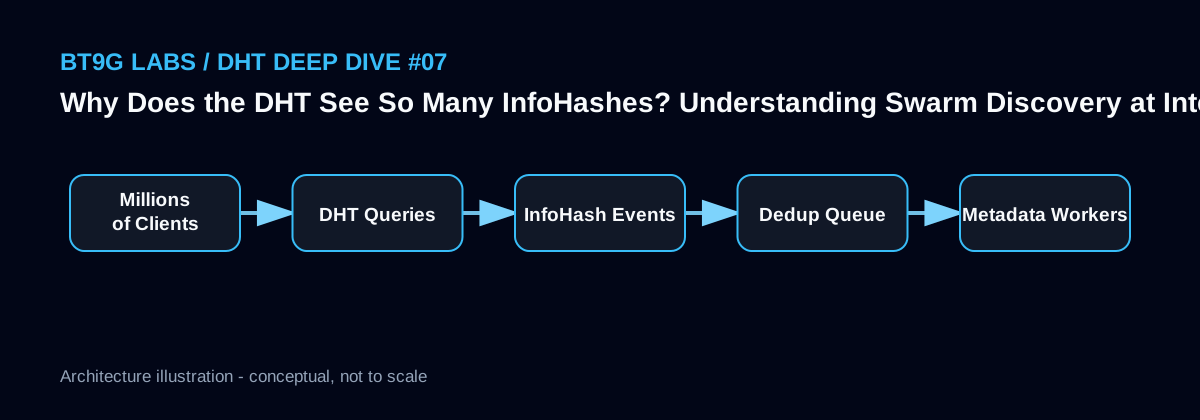
Un InfoHash popular puede repetirse miles de veces. Otros pueden pertenecer a Swarm muertos, clientes defectuosos o ruido malicioso. Un packet rate alto no equivale a la misma cantidad de contenido nuevo indexable.
Conviene separar observation events, unique hashes, active hashes y metadata-success hashes.
Deduplication y actividad
Cuando vuelve a aparecer un hash conocido, normalmente basta con actualizar last_seen, counters o activity score en lugar de lanzar otro Metadata fetch. Bloom filters y hot caches reducen mucho el coste del hot path.
La actividad puede ayudar al ranking, pero no es un contador exacto de usuarios o descargas globales.
Esquema de implementación
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Llamar total global a la cifra de un solo crawler.
- Mezclar eventos con InfoHash únicos.
- Relanzar Metadata fetch por cada repetición.
- Interpretar activity como número exacto de descargas.
Artículos relacionados de BT9G Labs
- Mensajes DHT de BEP 5: ping, find_node, get_peers y announce_peer
- Dentro de una DHT Routing Table: k-Bucket, Node Churn y selección de contactos
- Cómo un DHT Crawler descubre InfoHash: Active Lookup, observación y diseño responsable
- De Magnet Link a Metadata: flujo completo de Peer Discovery y BEP 9/10
Referencias
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.