BT9G LABS / DHT a fondo #02
Kademlia explicado: distancia XOR, routing y por qué BitTorrent DHT escala
Explicación práctica de XOR distance, lookup iterativo, paralelismo y k-bucket en el routing de una DHT tipo Kademlia.
BT9G Labs / DHT Deep Dive #02. Cómo una red de millones de nodos puede localizar objetivos manteniendo solo una cantidad limitada de contactos.
Resumen rápido
- Tema: Kademlia explicado: distancia XOR, routing y por qué BitTorrent DHT escala
- Palabras clave: Kademlia, XOR distance, DHT routing, k-bucket, lookup iterativo
- Audiencia: ingenieros backend, investigadores de protocolos, ingenieros de búsqueda e implementadores de BitTorrent
- Objetivo: Explicar el mecanismo con suficiente precisión como para apoyar decisiones reales de arquitectura de crawling, indexación y búsqueda.
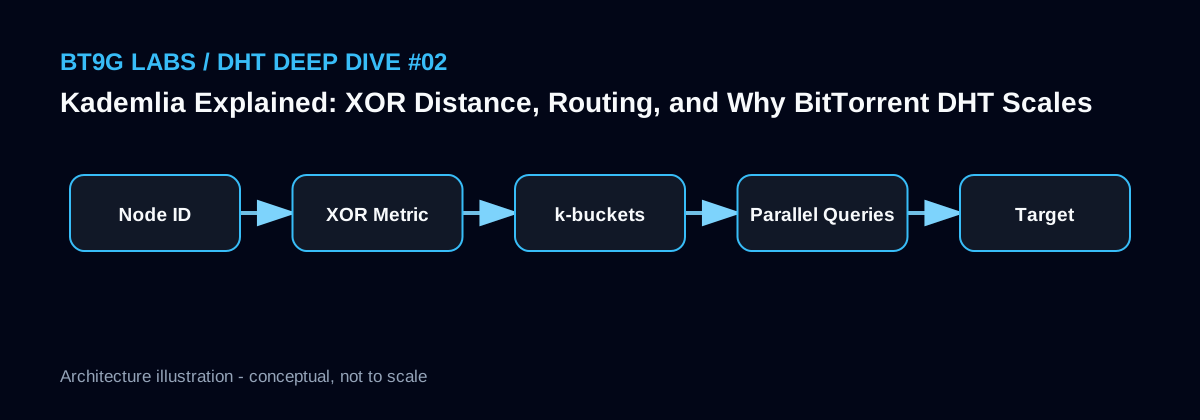
Vista del sistema
Por qué importa la distancia XOR
Kademlia coloca Node ID y claves objetivo en el mismo espacio lógico y utiliza XOR para comparar distancias. La métrica es determinista, simétrica y fácil de ordenar, por lo que cada nodo puede decidir qué contactos están lógicamente más cerca sin conocer toda la red.
La cercanía XOR no es cercanía geográfica ni menor RTT. Dos hosts en el mismo centro de datos pueden estar muy lejos en el espacio de IDs, y dos nodos en continentes distintos pueden estar cerca.
Por qué los lookups convergen
El cliente elige varios contactos cercanos al objetivo, consulta en paralelo y agrega a la frontera los nodos aún más cercanos devueltos en las respuestas. En cada ronda se reduce la distancia lógica hasta obtener el resultado o dejar de encontrar candidatos mejores.
Esta propiedad permite escalar: cada nodo mantiene una cobertura limitada de diferentes rangos, no una lista completa de la red.
k-bucket e implicaciones para crawlers
La routing table se organiza en k-bucket por rangos de distancia. En una red con mucho churn, un nodo antiguo que ha respondido repetidamente suele ser más valioso que una dirección recién observada.
Un crawler eficiente mantiene routing knowledge, limita paralelismo, controla timeouts y evita consultas duplicadas. Métricas como RTT pueden ayudar a planificar, pero no deben sustituir la lógica XOR fundamental de Kademlia.
Esquema de implementación
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
Notas de ingeniería de BT9G Labs
En un indexador como BT9G importa más separar correctamente la identidad del contenido, las observaciones de red de corta duración, el estado de adquisición y los documentos de búsqueda que maximizar el número bruto de eventos. Cada campo derivado de DHT o de un Peer debería conservar su fuente y marca temporal, y las métricas deberían dividirse por etapas: discovery, conexión, handshake, soporte de extensiones, obtención de Metadata, validación, almacenamiento e indexación.
Errores comunes
- Interpretar XOR distance como distancia física o latencia.
- Creer que cada nodo debe almacenar toda la DHT.
- Optimizar solo por tamaño de routing table.
- Ignorar paralelismo y timeouts durante el lookup.
Artículos relacionados de BT9G Labs
- ¿Qué es DHT? Guía práctica de la tabla hash distribuida de BitTorrent
- Cómo BitTorrent DHT encuentra Peer: de bootstrap a get_peers y announce_peer
- InfoHash a fondo: BitTorrent v1, v2, Magnet, BTIH y BTMH
Referencias
Siguiente artículo: Cómo BitTorrent DHT encuentra Peer: de bootstrap a get_peers y announce_peer →
Este artículo describe el comportamiento de protocolos públicos de BitTorrent con fines de ingeniería e investigación; no implica que todo Swarm observado esté disponible, sea válido o esté autorizado para su redistribución.