
BT9G LABS / DHT 深度解析 #18
为什么失败的 InfoHash 也应该保留:长期重试调度器设计
设计能够保留历史哈希、对冷 Swarm 做退避,并在新活动出现时快速重新激活的长期 Metadata 重试系统。
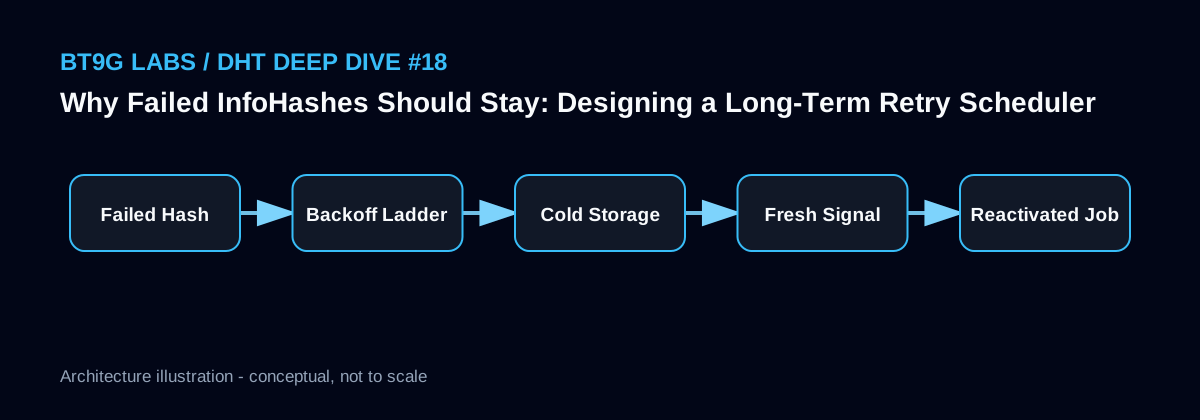
BT9G Labs / DHT Deep Dive #18. 一次失败只是某个时间点的网络结果,不应该成为永久墓碑;真正有效的是可衰减、可唤醒的重试状态机。
快速摘要
- 主题: 为什么失败的 InfoHash 也应该保留:长期重试调度器设计
- 核心关键词: InfoHash 重试, exponential backoff, 冷 Swarm, 任务调度, Metadata retry
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
系统视图
失败时间戳不是墓碑
一个今天无法获取 Metadata 的 InfoHash,几周后可能因为新的 Seeder 或 Peer 出现而重新活跃。删除这些失败键会丢失长期资产,也意味着未来再次看到它时无法利用历史状态。
更合适的做法是保留 compact durable record,并把它放入越来越低频的 retry schedule。存储一个哈希和少量状态很便宜,持续高频网络尝试才昂贵。
Backoff 应该反映失败类型
DHT lookup 暂时超时、Peer connect refused、对方不支持 ut_metadata、Metadata hash mismatch,这些错误的含义不同。网络短暂失败可以较快重试,而连续多次“无任何 Peer”的冷资源可以指数退避到数天甚至更久。
分类重试能同时控制成本并提高成功率,避免一个固定间隔对所有任务都过于激进或过于迟缓。
新活动应覆盖旧的悲观判断
如果一个哈希已经进入很长的 backoff,但今天又从 DHT 观察到新的 announce、Peer 或 Tracker 活动,就应该立即重新计算优先级。实时信号比几个月前的失败记录更有价值。
系统可以把 activity event 视为 wake-up trigger,把 next_attempt_at 拉回当前窗口,并优先尝试新的 Peer candidates。
重试队列必须持久化
只把 retry heap 放在进程内存里,一旦部署或故障重启就会丢失数百万任务的下一次执行时间。大规模长期调度应该让 durable store 保存状态,由 worker 按时间窗口领取任务。
同时需要防止重复领取、处理 worker crash 和超时 lease,使同一个任务最终可以再次被调度但不会在正常情况下被大量重复执行。
实现示意
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 失败一次就删除 InfoHash。
- 所有错误都用同一重试周期。
- 新活动出现时仍机械等待旧 backoff。
- 只在内存中维护长期 retry queue。
相关 BT9G Labs 文章
- 每分钟获取 1,000+ 条 Torrent Metadata,需要什么样的架构?
- 数十亿 InfoHash 如何去重?避免重复 Metadata 工作的多层设计
- 构建 BitTorrent 搜索索引:从 DHT、Metadata 到 Elasticsearch
- BT9G 如何规模化索引 BitTorrent Metadata:参考 DHT 架构
参考资料
下一篇: 构建 BitTorrent 搜索索引:从 DHT、Metadata 到 Elasticsearch →
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。