BT9G LABS / DHT 深度解析 #16
每分钟获取 1,000+ 条 Torrent Metadata,需要什么样的架构?
围绕成功吞吐、Peer discovery、连接成功率、timeout budget 和调度并发,反推千条/分钟级 Metadata pipeline。
BT9G Labs / DHT Deep Dive #16. 从目标成功吞吐倒推并发与资源,而不是把“发出多少请求”误当成 Metadata 采集能力。
快速摘要
- 主题: 每分钟获取 1,000+ 条 Torrent Metadata,需要什么样的架构?
- 核心关键词: 1000 metadata/min, Metadata pipeline, 并发, Little's Law, BitTorrent crawler
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
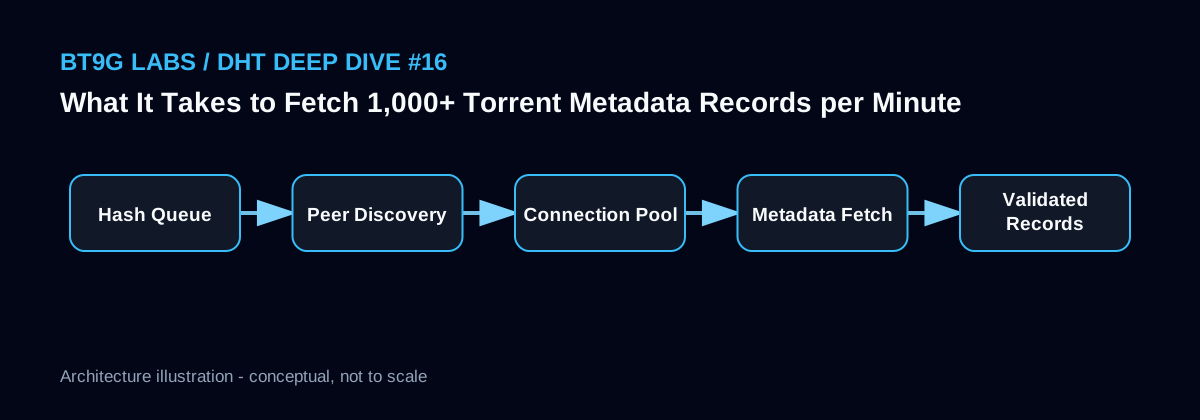
系统视图
从成功吞吐开始算
1,000 条/分钟约等于 16.7 条成功 Metadata/秒。真正需要的连接尝试数量取决于 Peer discovery 命中率、连接成功率、扩展支持率和 Metadata 完成率。如果端到端只有 20% 尝试最终成功,那么系统可能需要每秒发起八十多次有效尝试。
因此“每分钟收到多少 InfoHash”与“每分钟拿到多少 Metadata”是完全不同的容量指标。
Little's Law 可以做第一轮估算
如果一个成功或失败任务平均占用 5 秒,而目标处理速率是 80 个尝试/秒,那么仅从平均值看就可能需要约 400 个并发中的任务。真实系统还要考虑长尾 timeout,因此并发预算通常更高。
不过无限提高并发不会线性增加吞吐。socket、NAT、文件描述符、出站带宽、CPU 解析和远端 Peer 限制都会让收益递减。
Peer discovery 可能才是隐藏瓶颈
Metadata worker 再快,如果上游只能提供很少的高质量 Peer candidates,最终成功率仍然上不去。应该分别统计每个 InfoHash 获取到的 Peer 数、连接成功率、BEP 10 支持率和 ut_metadata 支持率。
优先选择近期活跃、曾成功响应、来自多个独立来源的 Peer,往往比盲目扩大连接并发更有效。
主机与网络资源边界
2c4g 是否足够不能只看理论并发。Go 本身可以管理很多 socket,但 DNS、NAT、conntrack、内核 UDP/TCP buffer、带宽、磁盘写入和数据库 RTT 都可能先成为限制。
正确方式是在目标部署地区做压测,并把 p50/p95/p99 时延、队列长度和失败原因一起记录,再决定单机扩容还是横向增加 worker。
实现示意
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 把发现 1,000 个 InfoHash 当成拿到 1,000 条 Metadata。
- 只按平均延迟计算并发而忽略长尾 timeout。
- Metadata worker 很多却没有足够高质量 Peer。
- 不做真实网络压测就承诺固定服务器规格的吞吐。
相关 BT9G Labs 文章
- 为什么 Torrent Metadata 获取会失败?10 个真实原因与更好的重试模型
- 高性能 DHT Crawler 架构:队列、背压与资源边界
- 数十亿 InfoHash 如何去重?避免重复 Metadata 工作的多层设计
- 为什么失败的 InfoHash 也应该保留:长期重试调度器设计
参考资料
下一篇: 数十亿 InfoHash 如何去重?避免重复 Metadata 工作的多层设计 →
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。