BT9G LABS / DHT 深度解析 #20
BT9G 如何规模化索引 BitTorrent Metadata:参考 DHT 架构
一套面向 BT9G Labs 的参考架构,把 DHT discovery、持久化 InfoHash 状态、Metadata acquisition、搜索索引和可观测性连接起来。
BT9G Labs / DHT Deep Dive #20. 把前 19 篇中的协议与工程原则组合成一套可扩展参考架构,说明 BT9G 一类搜索系统应该如何拆层。
快速摘要
- 主题: BT9G 如何规模化索引 BitTorrent Metadata:参考 DHT 架构
- 核心关键词: BT9G, DHT 架构, Metadata indexing, BitTorrent search, 分布式 crawler
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
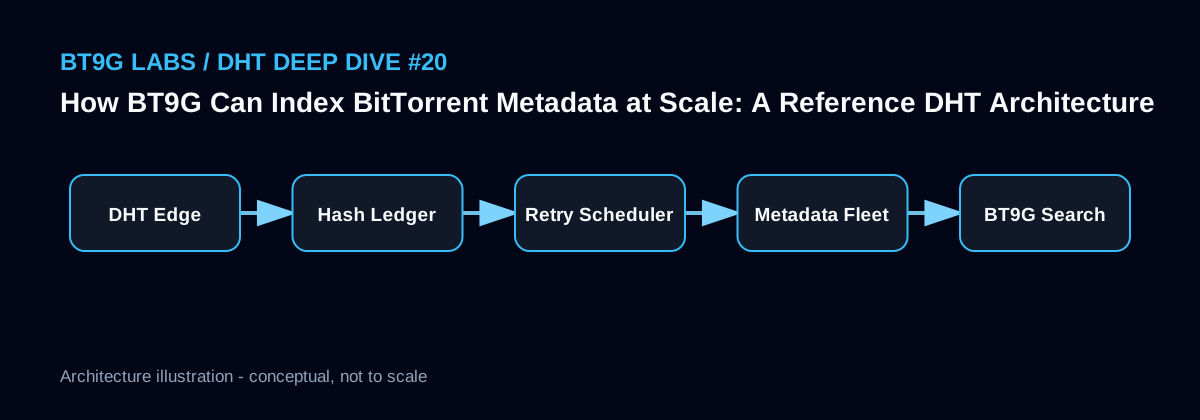
系统视图
第一层:Discovery Edge
最外层是一组长期在线的 DHT nodes/crawlers,负责参与公共 DHT、维护 routing table、处理 KRPC,并把观察到的 InfoHash 与 Peer activity 变成轻量事件。这个层的职责是高吞吐、低延迟和协议正确,而不是同步完成 Metadata。
多个区域的 discovery worker 可以提高网络视角多样性,但需要共享去重和 ownership 规则,避免只是重复制造相同任务。
第二层:Hash Ledger
所有内容身份进入持久化 hash ledger。它负责 exact dedup、first_seen/last_seen、状态机、失败类型、next_retry、活动计数和 Metadata identity 关系。这个 ledger 才是长期积累的核心资产。
Peer endpoints 不应该与内容身份同寿命保存;它们更适合进入带 TTL 的短期 candidate store,并记录最近来源与可连接质量。
第三层:Metadata Acquisition Fleet
调度器根据活动度、历史失败和资源预算挑选需要尝试的 InfoHash,worker 从 DHT/Tracker/历史数据获取 Peer candidates,建立连接并通过 BEP 10/BEP 9 拉取 Metadata。所有完成数据必须经过身份校验后才能升级为 canonical metadata。
worker 数量可以独立扩缩容,timeout 与并发应围绕成功率、p95 latency 和主机资源动态调整。
第四层:Serving、Ranking 与 Observability
经过验证的内容进入 canonical store,并派生到 Elasticsearch 等搜索层。查询服务只读取面向用户的稳定字段和经过解释的活动信号。排名可以结合文本相关性、新鲜度、最近网络活动和数据质量。
整个系统还需要统一 observability:从 UDP queries、unique hashes、Peer connection、BEP support、Metadata success 到 indexing lag 都应可追踪。只有这样,BT9G 才能知道新增资源速度究竟受哪一层限制。
实现示意
DHT observers
    |
    v
Hash event bus ---> metrics
    |
    v
Exact hash ledger <---- fresh activity wakes cold hashes
    |
    v
Retry / priority scheduler
    |
    v
Metadata fleet -> hash validation -> canonical metadata DB
                                   |
                                   v
                              enrichment
                                   |
                                   v
                              search index
                                   |
                                   v
                                BT9G
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 让 discovery worker 同时承担所有 Metadata 和索引职责。
- 把易失 Peer endpoints 当成和 InfoHash 一样的永久实体。
- 未验证 Metadata 就进入搜索 serving 层。
- 只有总吞吐指标,没有每个阶段的成功率和延迟指标。
相关 BT9G Labs 文章
参考资料
- BEP 5 - DHT Protocol
- BEP 9 - Extension for Peers to Send Metadata Files
- BEP 10 - Extension Protocol
- BEP 11 - Peer Exchange (PEX)
- BEP 48 - Tracker Protocol Extension: Scrape
- BEP 52 - The BitTorrent Protocol Specification v2
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。