
BT9G LABS / DHT 詳解 #06
DHT Routing Tableの内部:k-Bucket、Node Churn、連絡先選択
k-bucket が DHT contacts をどう整理し、なぜ安定 node が重要なのかを解説します。
BT9G Labs / DHT Deep Dive #06. Routing table は全 node の名簿ではなく、限られた容量で到達可能性を維持する動的キャッシュです。
クイックサマリー
- テーマ: DHT Routing Tableの内部:k-Bucket、Node Churn、連絡先選択
- 主要キーワード: k-bucket, DHT routing table, node churn, Kademlia, contact selection
- 対象読者: バックエンドエンジニア、プロトコル研究者、検索エンジニア、BitTorrent 実装者
- 目的: DHT と BitTorrent の仕組みを、実際のクローラ・インデックス・検索基盤の設計判断に使える精度で説明すること。
システム構成
距離帯で分ける理由
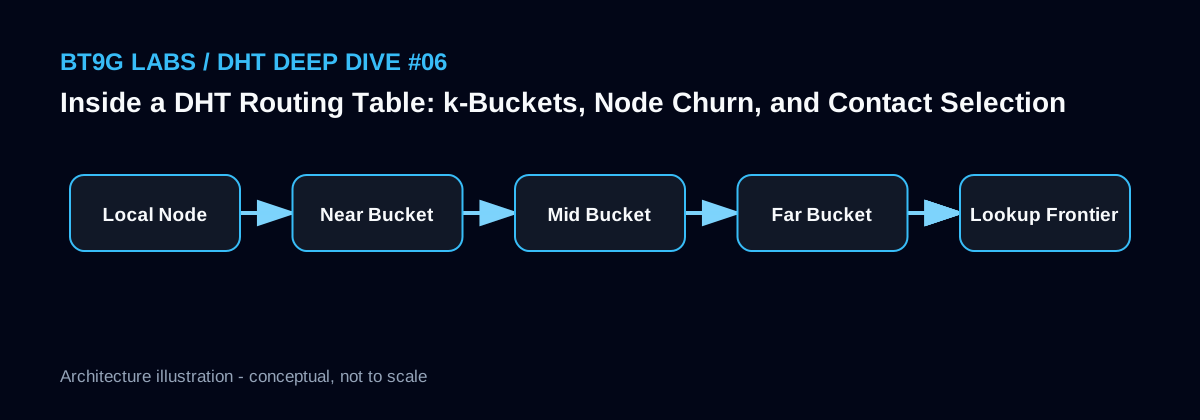
Kademlia は 1 つの巨大な contact list ではなく、XOR 距離帯ごとの k-bucket で routing table を構成します。各 bucket は有限容量なので、node はメモリを制御しながらキー空間全体への経路を残せます。
自分の Node ID 周辺は細かく、遠距離は粗くカバーすることで、少数 contact でも全体探索が可能になります。
古く安定した node の価値
P2P では churn が大きく、IP/port や NAT mapping は頻繁に変化します。そのため何度も応答した node は、新しく 1 回だけ見えた node より将来も生きている確率が高いことがあります。
last_seen、RTT、failure count を補助指標として使えますが、安定 contact を無条件に新規 contact で置き換えるべきではありません。
Refresh と永続化
長時間使っていない bucket は refresh して可用 contact を補い、一部実装では自分に近い bucket を split します。routing table をディスクに保存すれば再起動は速くなりますが、復元した contact は再検証が必要です。
Routing table は「今のところ使えそうな候補集合」であって永続的真実ではありません。
実装スケッチ
type Contact struct {
    ID        [20]byte
    IP        net.IP
    Port      uint16
    LastSeen  time.Time
    Failures  uint8
    RTT       time.Duration
}
BT9G Labs エンジニアリングノート
BT9G のようなインデックス基盤では、イベント件数そのものより、コンテンツ ID、短命なネットワーク観測、取得状態、検索用ドキュメントを分離することが重要です。DHT や Peer から得た値には取得元と時刻を持たせ、discovery、接続、handshake、拡張対応、Metadata 取得、検証、保存、検索反映を段階別に計測すると、実際のボトルネックを特定しやすくなります。
よくある誤解
- routing table を全 DHT node の DB と考える。
- 新 node を見たら常に古い node を捨てる。
- 長期間 bucket refresh をしない。
- 保存 contact を再起動後に無条件で信頼する。
関連する BT9G Labs 記事
- InfoHash徹底解説:BitTorrent v1・v2、Magnet、BTIH、BTMH
- BEP 5 DHTメッセージ解説:ping、find_node、get_peers、announce_peer
- なぜDHTでは大量のInfoHashが見えるのか:インターネット規模のSwarm Discovery
- DHT CrawlerはどうInfoHashを発見する?Active Lookupと観測設計
参考資料
次の記事: なぜDHTでは大量のInfoHashが見えるのか:インターネット規模のSwarm Discovery →
本記事は公開 BitTorrent プロトコルの挙動を技術・研究目的で解説するものであり、観測されたすべての Swarm が利用可能、正当、または再配布を許可されていることを意味しません。