
BT9G LABS / DHT 詳解 #02
Kademliaを解説:XOR距離、ルーティング、BitTorrent DHTがスケールする理由
XOR distance、反復 lookup、並列性、k-bucket が Kademlia 型 DHT を支える仕組みを実務目線で解説します。
BT9G Labs / DHT Deep Dive #02. ネットワーク全体を知らなくても目的のキーに到達できる、Kademlia のルーティング原理を整理します。
クイックサマリー
- テーマ: Kademliaを解説:XOR距離、ルーティング、BitTorrent DHTがスケールする理由
- 主要キーワード: Kademlia, XOR distance, DHT routing, k-bucket, iterative lookup
- 対象読者: バックエンドエンジニア、プロトコル研究者、検索エンジニア、BitTorrent 実装者
- 目的: DHT と BitTorrent の仕組みを、実際のクローラ・インデックス・検索基盤の設計判断に使える精度で説明すること。
システム構成
XOR距離が重要な理由
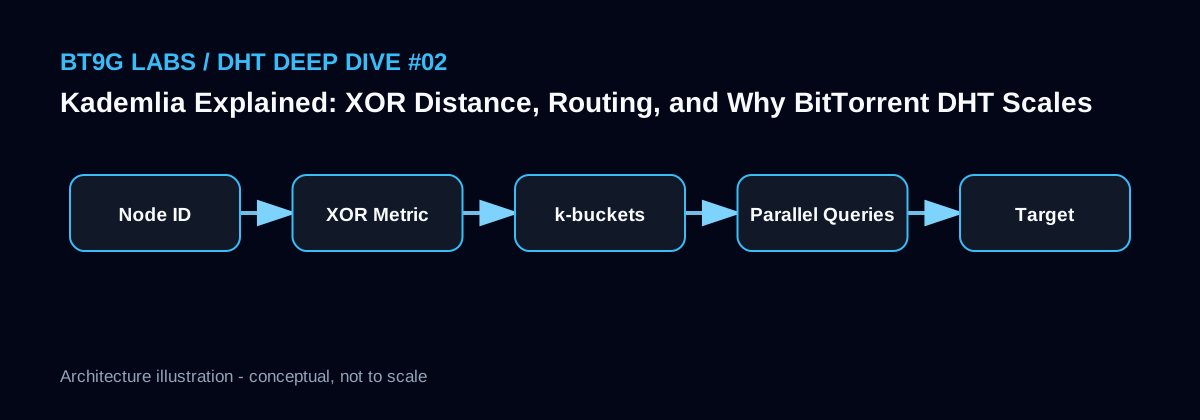
Kademlia は Node ID と検索対象を同じ論理キー空間に置き、XOR の値で距離を比較します。この距離は決定的かつ対称で、各 node は全ネットワークを知らなくても「どの連絡先が目的地により近いか」を選べます。
ここでの距離は地理や RTT ではありません。同じデータセンター内でも ID 空間では遠い場合があり、別大陸でも近いことがあります。
Lookup が収束する仕組み
クライアントは routing table から目的に近い複数 node を選び、並列に問い合わせます。応答に含まれるさらに近い node を候補へ追加し、未照会の中から再び最も近いものを選びます。反復するたびに XOR 距離が縮まり、結果か、これ以上近づけない状態に到達します。
この仕組みにより、各 node は少数の良質な連絡先だけを持ちながら大規模ネットワークを探索できます。
k-bucket とクローラ設計
Routing table は XOR 距離帯ごとの k-bucket に分かれます。長時間応答している安定 node は、高 churn な P2P ネットワークでは特に価値があります。新しい IP を見たからといって即座に古い安定 node を捨てるべきではありません。
Crawler は routing knowledge、timeout、並列度、重複照会を管理し、RTT などの補助指標は使っても、Kademlia の「論理的に近い node をたどる」原則自体を壊さないことが重要です。
実装スケッチ
def xor_distance(a: bytes, b: bytes) -> int:
    return int.from_bytes(a, 'big') ^ int.from_bytes(b, 'big')

contacts.sort(key=lambda n: xor_distance(n.node_id, target))
closest = contacts[:8]
BT9G Labs エンジニアリングノート
BT9G のようなインデックス基盤では、イベント件数そのものより、コンテンツ ID、短命なネットワーク観測、取得状態、検索用ドキュメントを分離することが重要です。DHT や Peer から得た値には取得元と時刻を持たせ、discovery、接続、handshake、拡張対応、Metadata 取得、検証、保存、検索反映を段階別に計測すると、実際のボトルネックを特定しやすくなります。
よくある誤解
- XOR距離をネットワーク距離と考える。
- 各 node が全 DHT node を保存すると考える。
- routing table の大きさだけを重視する。
- 並列 lookup と timeout の影響を無視する。
関連する BT9G Labs 記事
- DHTとは?BitTorrentの分散ハッシュテーブルを実践的に理解する
- BitTorrent DHTはどうPeerを見つける?Bootstrapからget_peers・announce_peerまで
- InfoHash徹底解説:BitTorrent v1・v2、Magnet、BTIH、BTMH
参考資料
次の記事: BitTorrent DHTはどうPeerを見つける?Bootstrapからget_peers・announce_peerまで →
本記事は公開 BitTorrent プロトコルの挙動を技術・研究目的で解説するものであり、観測されたすべての Swarm が利用可能、正当、または再配布を許可されていることを意味しません。