
BT9G LABS / DHT 詳解 #07
なぜDHTでは大量のInfoHashが見えるのか:インターネット規模のSwarm Discovery
DHT 観測で活発・重複・古い・低品質な InfoHash が大量に流れる理由を解説します。
BT9G Labs / DHT Deep Dive #07. 大量の hash event と、実際に取得できる有効 Metadata の数が一致しない理由を理解します。
クイックサマリー
- テーマ: なぜDHTでは大量のInfoHashが見えるのか:インターネット規模のSwarm Discovery
- 主要キーワード: DHT InfoHash, Swarm discovery, BitTorrent activity, deduplication, DHT crawler
- 対象読者: バックエンドエンジニア、プロトコル研究者、検索エンジニア、BitTorrent 実装者
- 目的: DHT と BitTorrent の仕組みを、実際のクローラ・インデックス・検索基盤の設計判断に使える精度で説明すること。
システム構成
中央レジストリは存在しない
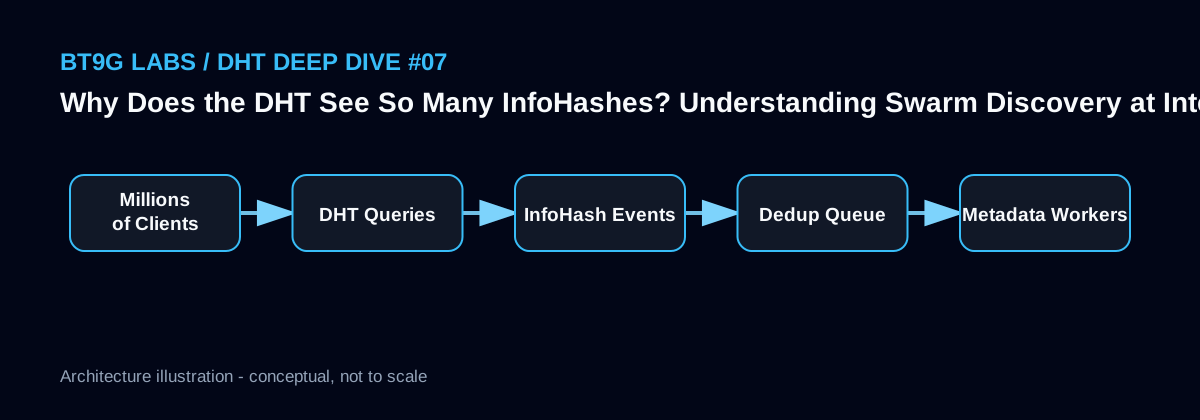
DHT に「全 Torrent 一覧」はありません。InfoHash は Peer の lookup、announce、crawler の探索など、ネットワーク活動によって観測されます。ある crawler が見える集合は、稼働時間、routing position、探索戦略、地域などに左右されます。
したがって「1 日の世界全体の新規 InfoHash」を単一観測点から厳密に算出することはできません。
イベントストリームにはノイズが多い
人気 InfoHash は何度も繰り返し見え、古い Swarm や壊れたクライアント由来の値、意図的ノイズも混ざります。packet/event rate が高くても unique content の増加が同じだけあるわけではありません。
observation events、unique hashes、active hashes、metadata-success hashes を別メトリクスにする必要があります。
Dedup と activity signal
重複を見つけるたびに Metadata fetch をやり直すのではなく、content identity は 1 度だけ保存し、last_seen、observation count、activity score を更新します。Bloom filter や hot cache はこの熱経路で有効です。
Activity はランキング信号にはなりますが、正確なユーザー数や download count ではありません。
実装スケッチ
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
BT9G Labs エンジニアリングノート
BT9G のようなインデックス基盤では、イベント件数そのものより、コンテンツ ID、短命なネットワーク観測、取得状態、検索用ドキュメントを分離することが重要です。DHT や Peer から得た値には取得元と時刻を持たせ、discovery、接続、handshake、拡張対応、Metadata 取得、検証、保存、検索反映を段階別に計測すると、実際のボトルネックを特定しやすくなります。
よくある誤解
- 単一 crawler の値を世界全体の正確な新規数と呼ぶ。
- event 数と unique InfoHash 数を混同する。
- 重複 observation ごとに Metadata fetch を起動する。
- DHT activity を正確なダウンロード人数として扱う。
関連する BT9G Labs 記事
- BEP 5 DHTメッセージ解説:ping、find_node、get_peers、announce_peer
- DHT Routing Tableの内部:k-Bucket、Node Churn、連絡先選択
- DHT CrawlerはどうInfoHashを発見する?Active Lookupと観測設計
- Magnet LinkからMetadataへ:Peer DiscoveryとBEP 9/10の完全フロー
参考資料
次の記事: DHT CrawlerはどうInfoHashを発見する?Active Lookupと観測設計 →
本記事は公開 BitTorrent プロトコルの挙動を技術・研究目的で解説するものであり、観測されたすべての Swarm が利用可能、正当、または再配布を許可されていることを意味しません。