
BT9G LABS / DHT Deep Dive #18
Mengapa InfoHash yang Gagal Harus Tetap Disimpan: Merancang Retry Scheduler Jangka Panjang
Rancang retry scheduler yang menyimpan InfoHash gagal, memakai backoff berbasis failure class, menerima sinyal reaktivasi, dan menjaga queue tetap durable.
BT9G Labs / DHT Deep Dive #18. Swarm P2P bersifat dinamis; kegagalan hari ini tidak cukup untuk menyimpulkan bahwa metadata tidak akan pernah tersedia lagi.
Ringkasan cepat
- Topik: Mengapa InfoHash yang Gagal Harus Tetap Disimpan: Merancang Retry Scheduler Jangka Panjang
- Kata kunci utama: InfoHash retry, retry scheduler, exponential backoff, reactivation signal, DHT metadata
- Untuk pembaca: engineer backend, peneliti protokol, search engineer, dan pengembang implementasi BitTorrent
- Tujuan: Menjelaskan protokol dan desain sistem dengan cukup presisi agar dapat diterapkan pada pipeline discovery, metadata, indexing, dan search di dunia nyata.
Gambaran sistem
Timestamp kegagalan bukan tombstone
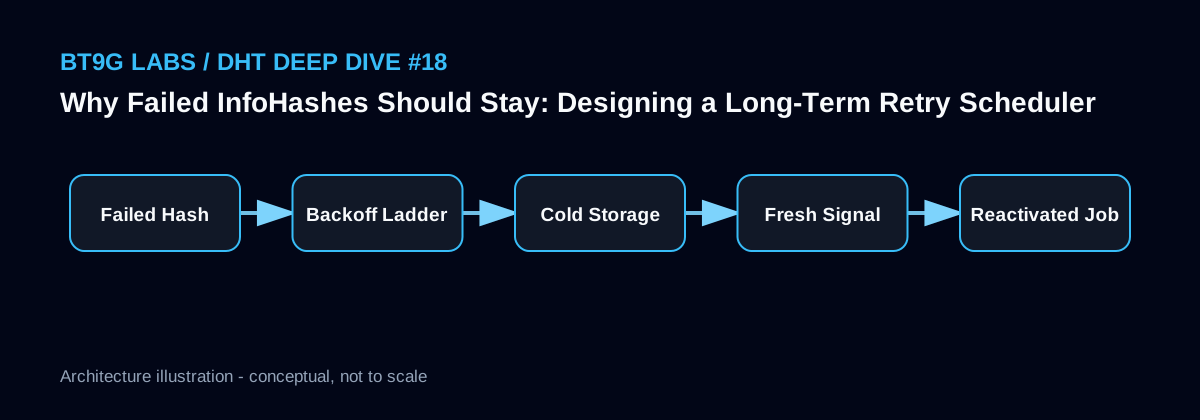
Peer dapat offline saat crawler mencoba, lalu aktif lagi beberapa hari kemudian. Tracker dapat pulih, DHT dapat menemukan endpoint baru, atau pengguna baru dapat menghidupkan kembali Swarm lama. Menghapus InfoHash setelah gagal membuang kesempatan tersebut.
Lebih baik simpan record identitas dan riwayat attempt secara ringkas. Status 'dormant' atau 'retry later' lebih sesuai daripada 'dead forever'.
Backoff harus mengikuti jenis kegagalan
Connect timeout, no peers, extension unsupported, metadata reject, dan hash mismatch memiliki karakter berbeda. No peers mungkin dicoba lagi setelah interval menengah, sementara repeated hash mismatch dari beberapa sumber dapat diberi interval lebih panjang.
Tambahkan jitter agar jutaan job tidak bangun bersamaan pada batas waktu yang sama. Batasi retry budget untuk menjaga pekerjaan baru tetap mendapat kapasitas.
Aktivitas baru harus mengalahkan pesimisme lama
Jika InfoHash yang sudah dormant kembali terlihat berkali-kali di DHT atau sumber lain memberikan Peer fresh, scheduler sebaiknya menaikkan prioritas dan memajukan next_retry_at. Ini disebut event-driven reactivation.
Dengan desain tersebut, backoff mengurangi pemborosan ketika tidak ada sinyal, tetapi sistem segera merespons ketika probabilitas sukses meningkat.
Queue retry harus durable
Jangan menyimpan jadwal hanya di memori. Restart deployment tidak boleh melupakan jutaan state retry atau mengulang semuanya dari nol. Gunakan database, durable queue, atau struktur time-indexed yang dapat direkonstruksi.
Worker harus memakai lease/idempotency sehingga beberapa instance tidak mengambil hash yang sama secara bersamaan tanpa alasan.
Sketsa implementasi
attempt 1: +30 minutes
attempt 2: +2 hours
attempt 3: +8 hours
attempt 4: +1 day
attempt 5: +7 days
attempt 6+: +30 days with jitter

fresh DHT observation => move next_retry closer
Catatan engineering BT9G Labs
Untuk sistem indeks seperti BT9G, metrik yang paling berguna bukan sekadar jumlah paket atau jumlah InfoHash yang terlihat. Pisahkan identitas konten, observasi jaringan, status akuisisi, metadata terverifikasi, serta dokumen pencarian menjadi lapisan data yang berbeda. Simpan sumber dan waktu observasi untuk data yang datang dari DHT atau Peer. Dengan begitu, bottleneck dapat dilacak dari tahap discovery, koneksi, handshake, negosiasi extension, pengambilan metadata, validasi, penyimpanan, hingga indexing.
Kesalahan umum
- Menghapus hash setelah satu failure.
- Menggunakan backoff yang sama untuk semua error class.
- Tidak memberi jitter pada jadwal besar.
- Menyimpan retry state hanya di memori proses.
Artikel BT9G Labs terkait
- Apa yang Dibutuhkan untuk Mengambil 1.000+ Metadata Torrent per Menit
- Cara Mendeduplikasi Miliaran Observasi InfoHash Tanpa Memboroskan Pekerjaan Metadata
- Membangun BitTorrent Search Index: Dari DHT ke Metadata hingga Elasticsearch
- Bagaimana BT9G Dapat Mengindeks Metadata BitTorrent pada Skala Besar: Arsitektur Referensi DHT
Referensi
Artikel berikutnya: Membangun BitTorrent Search Index: Dari DHT ke Metadata hingga Elasticsearch →
Artikel ini menjelaskan protokol BitTorrent publik dan pola engineering. Observasi terhadap sebuah Swarm tidak berarti kontennya tersedia, valid, atau diizinkan untuk didistribusikan.