BT9G LABS / DHT Deep Dive #17
Cara Mendeduplikasi Miliaran Observasi InfoHash Tanpa Memboroskan Pekerjaan Metadata
Desain deduplikasi untuk InfoHash skala besar dengan hot cache, Bloom filter, durable ledger, state scheduling, dan partitioning jangka panjang.
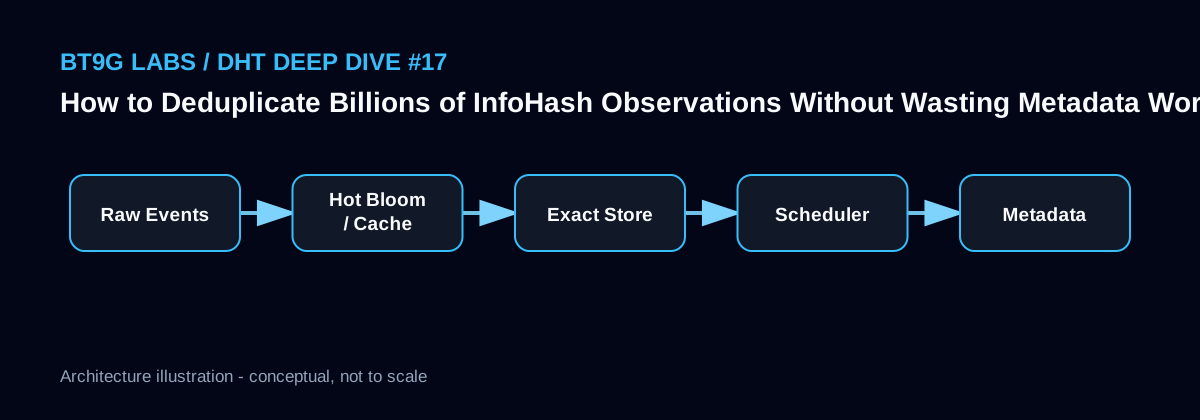
BT9G Labs / DHT Deep Dive #17. Deduplikasi bukan optimasi kecil; ia menentukan apakah crawler menghabiskan resource pada hash baru atau mengulang pekerjaan yang sama.
Ringkasan cepat
- Topik: Cara Mendeduplikasi Miliaran Observasi InfoHash Tanpa Memboroskan Pekerjaan Metadata
- Kata kunci utama: InfoHash deduplication, Bloom filter, Redis, hash ledger, large-scale crawler
- Untuk pembaca: engineer backend, peneliti protokol, search engineer, dan pengembang implementasi BitTorrent
- Tujuan: Menjelaskan protokol dan desain sistem dengan cukup presisi agar dapat diterapkan pada pipeline discovery, metadata, indexing, dan search di dunia nyata.
Gambaran sistem
Deduplikasi sebagai subsystem utama
InfoHash yang sama dapat terlihat berkali-kali dari node, waktu, dan collector berbeda. Sistem harus menggabungkan event tersebut ke identitas kanonik sambil tetap mempertahankan statistik observasi seperti first_seen, last_seen, source_count, dan activity_count.
Jika setiap event langsung membuat job metadata baru, workload akan meningkat sebanding traffic, bukan jumlah konten unik. Pada skala besar, itu pemborosan terbesar.
Filter probabilistik berada di depan, bukan menjadi source of truth
Bloom filter sangat efisien untuk menjawab 'mungkin pernah terlihat' dengan sedikit memori, tetapi memiliki false positive. Karena itu ia cocok menahan lookup database yang jelas duplikat, bukan menentukan secara final bahwa sebuah hash tidak perlu disimpan.
Redis set/cache juga berguna untuk hot window. Durable database atau key-value store tetap memegang record kanonik agar restart dan rotasi filter tidak menghilangkan sejarah.
Pisahkan existence dari scheduling state
Pertanyaan 'apakah hash ini pernah ada?' berbeda dari 'apakah metadata perlu diambil sekarang?'. Record identity dapat tetap selamanya sementara state scheduler berubah dari new, queued, fetching, verified, retry, atau dormant.
Pemisahan ini mencegah hash lama yang kembali aktif diperlakukan sebagai benar-benar baru dan memungkinkan fresh activity mengaktifkan retry tanpa membuat duplikat identitas.
Partition untuk pertumbuhan jangka panjang
Sharding berdasarkan prefix hash memberikan distribusi deterministik dan mempermudah ownership. Storage dapat dipisah antara ledger identitas, event agregat, metadata canonical, dan search index sehingga masing-masing dioptimalkan untuk pola aksesnya.
Jangan simpan setiap event mentah selamanya tanpa strategi retensi. Agregasi time-bucket atau compaction dapat mempertahankan sinyal penting dengan biaya lebih rendah.
Sketsa implementasi
CREATE TABLE infohash_state (
  hash VARBINARY(32) NOT NULL,
  hash_type TINYINT NOT NULL,
  first_seen DATETIME NOT NULL,
  last_seen DATETIME NOT NULL,
  seen_count BIGINT NOT NULL,
  metadata_status TINYINT NOT NULL,
  next_retry DATETIME NULL,
  PRIMARY KEY(hash_type, hash)
);
Catatan engineering BT9G Labs
Untuk sistem indeks seperti BT9G, metrik yang paling berguna bukan sekadar jumlah paket atau jumlah InfoHash yang terlihat. Pisahkan identitas konten, observasi jaringan, status akuisisi, metadata terverifikasi, serta dokumen pencarian menjadi lapisan data yang berbeda. Simpan sumber dan waktu observasi untuk data yang datang dari DHT atau Peer. Dengan begitu, bottleneck dapat dilacak dari tahap discovery, koneksi, handshake, negosiasi extension, pengambilan metadata, validasi, penyimpanan, hingga indexing.
Kesalahan umum
- Membuat metadata job untuk setiap observasi duplikat.
- Menjadikan Bloom filter sebagai satu-satunya sumber kebenaran.
- Mencampur status identitas dengan status scheduler.
- Menyimpan event mentah tanpa batas dan tanpa kebijakan retensi.
Artikel BT9G Labs terkait
- Merancang DHT Crawler Berperforma Tinggi: Arsitektur, Queue, dan Backpressure
- Apa yang Dibutuhkan untuk Mengambil 1.000+ Metadata Torrent per Menit
- Mengapa InfoHash yang Gagal Harus Tetap Disimpan: Merancang Retry Scheduler Jangka Panjang
- Membangun BitTorrent Search Index: Dari DHT ke Metadata hingga Elasticsearch
Referensi
Artikel ini menjelaskan protokol BitTorrent publik dan pola engineering. Observasi terhadap sebuah Swarm tidak berarti kontennya tersedia, valid, atau diizinkan untuk didistribusikan.