
BT9G LABS / DHT Deep Dive #16
Apa yang Dibutuhkan untuk Mengambil 1.000+ Metadata Torrent per Menit
Model kapasitas untuk 1.000+ metadata sukses per menit: concurrency, latency, success rate, Peer discovery, host limits, dan pipeline terdistribusi.
BT9G Labs / DHT Deep Dive #16. Target throughput harus dihitung dari metadata yang berhasil diverifikasi per menit, bukan sekadar jumlah request yang dikirim.
Ringkasan cepat
- Topik: Apa yang Dibutuhkan untuk Mengambil 1.000+ Metadata Torrent per Menit
- Kata kunci utama: 1000 metadata per minute, Torrent metadata throughput, concurrency, Little's Law, DHT architecture
- Untuk pembaca: engineer backend, peneliti protokol, search engineer, dan pengembang implementasi BitTorrent
- Tujuan: Menjelaskan protokol dan desain sistem dengan cukup presisi agar dapat diterapkan pada pipeline discovery, metadata, indexing, dan search di dunia nyata.
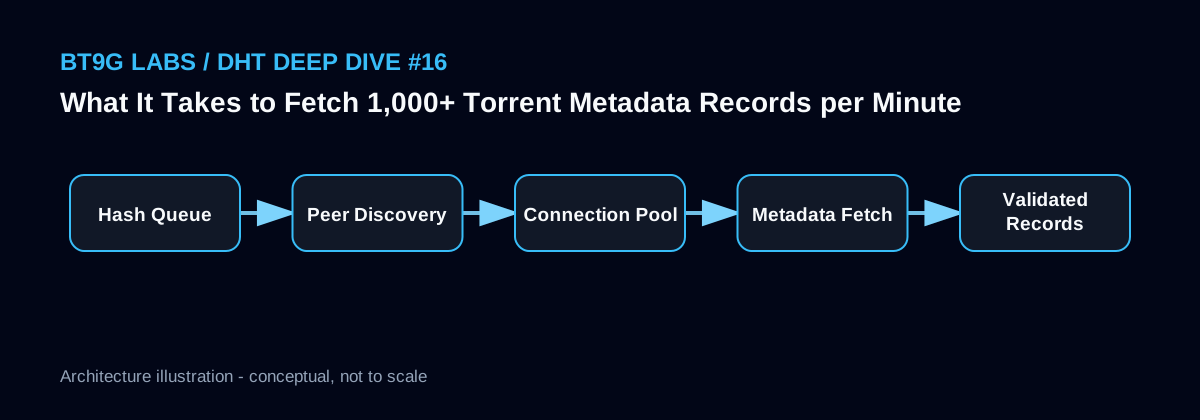
Gambaran sistem
Mulai dari success throughput
Seribu metadata per menit berarti sekitar 16,7 metadata terverifikasi per detik. Jika hanya 20% attempt berakhir sukses, sistem mungkin membutuhkan lebih dari 80 attempt per detik sebelum memperhitungkan retry dan timeout. Karena itu angka request tidak sama dengan output berguna.
Definisikan success sebagai metadata lengkap yang lolos hash verification dan berhasil disimpan. Ini membuat capacity planning terhubung langsung ke tujuan produk.
Little's Law sebagai estimasi awal
Jika satu attempt rata-rata memegang slot selama beberapa detik, concurrency yang dibutuhkan kira-kira arrival rate dikalikan waktu dalam sistem. Misalnya 80 attempt/detik dengan rata-rata 4 detik dapat membutuhkan ratusan koneksi simultan.
Namun distribusi latency memiliki ekor panjang. Timeout lambat dapat menghabiskan slot, sehingga deadline dan hedged/alternate Peer scheduling sering lebih penting daripada menaikkan concurrency mentah.
Peer discovery bisa menjadi bottleneck tersembunyi
Metadata worker tidak dapat bekerja jika tidak memiliki endpoint Peer berkualitas. DHT lookup, Tracker, PEX, dan cache candidate harus menyediakan cukup banyak Peer fresh. Banyak desain mengukur fetcher saja lalu bingung ketika worker idle.
Pisahkan metrik hashes_ready, peers_discovered, connect_success, ut_metadata_supported, dan metadata_verified. Funnel tersebut menunjukkan tahap mana yang membatasi throughput.
Batas host tetap penting
File descriptor, ephemeral ports, NAT table, kernel UDP buffers, TCP backlog, bandwidth, dan memory dapat membatasi satu host. Tuning kernel boleh membantu, tetapi scale-out biasanya lebih aman setelah satu host mencapai kurva diminishing return.
Gunakan beberapa fetcher dengan queue bersama dan idempotency. Dengan begitu kapasitas dapat ditambah tanpa mengubah seluruh sistem.
Sketsa implementasi
Target: 1000 validated metadata / minute
      = 16.7 successes / second

Required attempt rate ~= success_rate_target / end_to_end_success_ratio
Required concurrency ~= attempt_rate * average_session_seconds

Example only:
16.7 / 0.25 * 4s ~= 267 concurrent session slots
Catatan engineering BT9G Labs
Untuk sistem indeks seperti BT9G, metrik yang paling berguna bukan sekadar jumlah paket atau jumlah InfoHash yang terlihat. Pisahkan identitas konten, observasi jaringan, status akuisisi, metadata terverifikasi, serta dokumen pencarian menjadi lapisan data yang berbeda. Simpan sumber dan waktu observasi untuk data yang datang dari DHT atau Peer. Dengan begitu, bottleneck dapat dilacak dari tahap discovery, koneksi, handshake, negosiasi extension, pengambilan metadata, validasi, penyimpanan, hingga indexing.
Kesalahan umum
- Mengukur request rate sebagai metadata throughput.
- Mengasumsikan success rate 100%.
- Mengabaikan Peer discovery sebagai bagian capacity planning.
- Menaikkan concurrency sebelum memeriksa file descriptor, port, dan timeout.
Artikel BT9G Labs terkait
- Mengapa Pengambilan Torrent Metadata Gagal: 10 Penyebab Nyata dan Model Retry yang Lebih Baik
- Merancang DHT Crawler Berperforma Tinggi: Arsitektur, Queue, dan Backpressure
- Cara Mendeduplikasi Miliaran Observasi InfoHash Tanpa Memboroskan Pekerjaan Metadata
- Mengapa InfoHash yang Gagal Harus Tetap Disimpan: Merancang Retry Scheduler Jangka Panjang
Referensi
Artikel ini menjelaskan protokol BitTorrent publik dan pola engineering. Observasi terhadap sebuah Swarm tidak berarti kontennya tersedia, valid, atau diizinkan untuk didistribusikan.