
BT9G LABS / DHT 深度解析 #08
DHT Crawler 如何發現 InfoHash:主動查詢、網路觀察與負責任設計
從系統角度解釋 DHT crawler 如何發現 InfoHash,以及為甚麼發現、Metadata 獲取和索引必須拆成不同流水線。
BT9G Labs / DHT Deep Dive #08. 把 DHT 發現從 Metadata 採集里拆出來,理解主動 lookup、觀察事件、熱路徑和網路禮貌之間的平衡。
快速摘要
- 主題: DHT Crawler 如何發現 InfoHash:主動查詢、網路觀察與負責任設計
- 核心關鍵詞: DHT crawler, InfoHash 發現, 主動查詢, Metadata pipeline, BitTorrent
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
系統視圖
發現與獲取是兩條不同流水線
DHT crawler 最容易犯的架構錯誤,是把“看到一個 InfoHash”立即等同於“必須同步拿完 Metadata”。發現事件通常非常便宜且密集,而建立 Peer 連接、擴展握手和傳輸 Metadata 明顯更昂貴。
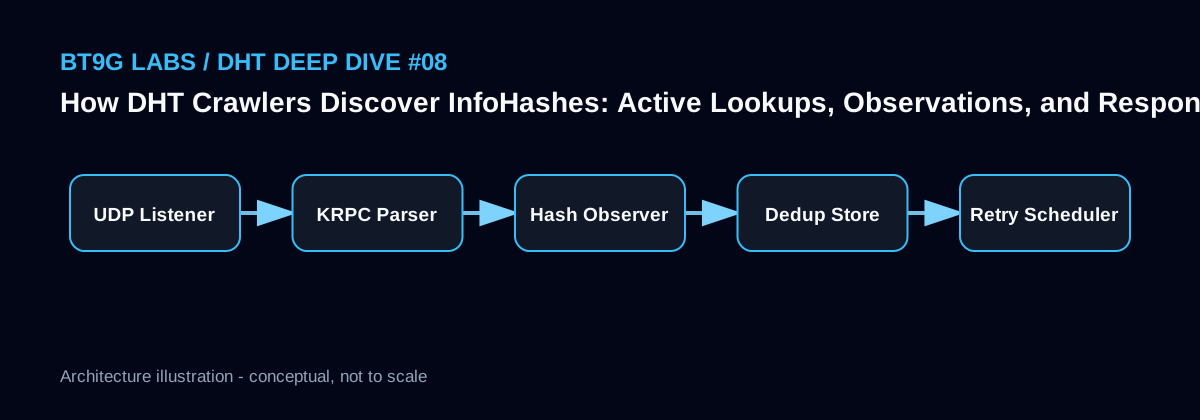
更合理的系統把 UDP discovery 作為高速入口,只做最小解析、去重和持久化,然後把需要嘗試 Metadata 的雜湊放入異步佇列,由另一組 worker 按資源預算處理。這樣才能在突發流量下保持穩定。
主動策略與觀察策略
主動 crawler 可以選擇目標鍵空間並執行 find_node / get_peers,借此不斷探索網路。另一方面,長期參與 DHT 本身也會收到其他節點發來的查詢,從中觀察到新的 InfoHash。兩種方式各有偏差,不應假裝能夠完整代表整個互聯網。
高質量實現會記錄每個發現信號的來源類型,以便後續判斷一個雜湊是由主動探索發現、對端請求暴露,還是其他資料源補充。
熱路徑應該非常輕
UDP packet handler 不適合執行資料庫慢查詢、Metadata 連接或複雜文本處理。它應該快速驗證報文、提取必要欄位、更新有限狀態並把後續工作交給有界佇列。所有可能阻塞的任務都應從 packet plane 中剝離。
如果入口速度超過下游處理能力,系統必須有 backpressure 或降級策略,而不是無限增加記憶體佇列。否則短暫流量高峰就可能導致 OOM。
負責任的網路行為
DHT 是公共 P2P 網路,不是無限免費的掃描基礎設施。crawler 應限制每節點請求頻率、避免對同一地址重復轟炸、使用合理 timeout,並遵守正常協議交互。為了追求數字好看而製造大量無效查詢,會降低自身成功率,也會給其他參與者帶來負擔。
工程優化的目標應該是單位請求獲得更高質量的資訊,而不是簡單最大化 UDP 包數量。
實現示意
func handlePacket(pkt []byte, from *net.UDPAddr) {
    msg, err := krpc.Parse(pkt)
    if err != nil { return }
    routing.Observe(msg.NodeID, from)
    if ih, ok := msg.InfoHash(); ok {
        observer.TryEmit(HashEvent{Hash: ih, SeenAt: time.Now()})
    }
}
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 每觀察到一個雜湊就同步啓動 Metadata 抓取。
- 在 UDP handler 里執行資料庫和網路慢任務。
- 宣稱單一採集策略覆蓋全網。
- 為了吞吐量量對相同節點進行高頻重復查詢。
相關 BT9G Labs 文章
- DHT Routing Table 內部原理:k-Bucket、節點 Churn 與聯繫人選擇
- 為甚麼 DHT 會看到海量 InfoHash?理解互聯網規模的 Swarm 發現
- Magnet 鏈接如何變成檔案 Metadata:完整 Peer 與 Metadata 流程
- BEP 9 ut_metadata 詳解:如何從 Peer 獲取 Torrent Metadata
參考資料
下一篇: Magnet 鏈接如何變成檔案 Metadata:完整 Peer 與 Metadata 流程 →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。