
BT9G LABS / DHT 深度解析 #06
DHT Routing Table 內部原理:k-Bucket、節點 Churn 與聯繫人選擇
理解 k-bucket 如何組織 DHT 聯繫人、為甚麼穩定節點更有價值,以及 routing table 如何在高 churn 網路中保持可用。
BT9G Labs / DHT Deep Dive #06. 從距離分段、節點替換到 bucket refresh,理解一個健康 DHT routing table 的真實行為。
快速摘要
- 主題: DHT Routing Table 內部原理:k-Bucket、節點 Churn 與聯繫人選擇
- 核心關鍵詞: k-bucket, DHT routing table, 節點 churn, Kademlia, 聯繫人選擇
- 適合讀者: 後端工程師、協議研究者、搜索工程師以及 BitTorrent 實現者
- 目標: 用足夠準確的協議與系統視角解釋原理,並能直接支持真實的採集、索引和搜索架構設計。
系統視圖
不是一張無限增長的節點列表
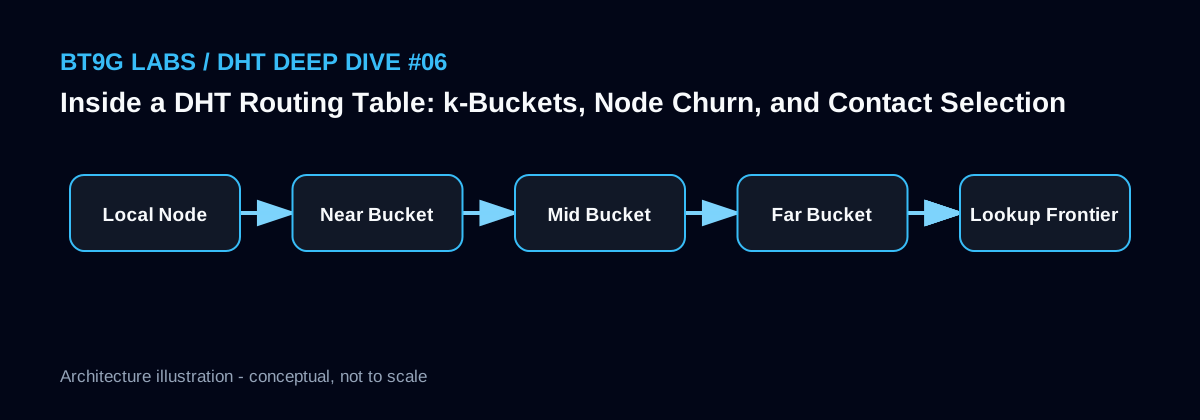
Kademlia routing table 的核心不是“盡可能保存更多 IP”,而是用 k-bucket 覆蓋不同 XOR 距離區間。每個 bucket 有容量上限,因此節點必須在有限記憶體下選擇哪些聯繫人值得長期保留。越接近自身 ID 的空間通常可以擁有更細的劃分,而較遠區域用更粗粒度覆蓋即可。
這種結構讓節點即使只認識全網極小一部分參與者,也仍然能找到通往任意目標區域的下一跳。
為甚麼老而穩定的節點很有價值
公網 P2P 網路具有很高 churn:家庭網路重啓、移動網路切換、NAT 對映變化都會讓聯繫人失效。經典 Kademlia 更願意保留已經多次證明可響應的節點,而不是看到一個新地址就立即淘汰舊節點。
這個策略看似保守,但實際能顯著提升查詢成功率。對長時間運行的 crawler 來說,也可以為聯繫人記錄 last_seen、RTT、失敗次數等輔助指標,在不違反協議邏輯的前提下優化發送策略。
Refresh、Split 與維護
長時間沒有流量的 bucket 可能需要主動 refresh,以確認該距離區間仍有可用節點。某些實現會在靠近本地 node ID 的 bucket 滿時進一步 split,使自身附近的路由資訊更精細。不同客戶端實現細節可能不同,但目標都是在固定資源預算內保持整個鍵空間可達。
維護邏輯應和業務查詢共享狀態,而不是建立兩套互相不瞭解的聯繫人快取,否則容易產生重復流量和不一致。
Routing table 是快取,不是事實資料庫
routing table 表示“目前看來值得聯繫的節點集合”,並不代表這些節點下一秒仍在線。持久化 routing table 可以幫助冷啓動,但恢復後仍然應該重新驗證。
同理,採集系統不要因為某節點曾經穩定就無限期信任它。可用性評分應該隨時間衰減,並允許最近成功響應重新提升優先級。
實現示意
type Contact struct {
    ID        [20]byte
    IP        net.IP
    Port      uint16
    LastSeen  time.Time
    Failures  uint8
    RTT       time.Duration
}
BT9G Labs 工程筆記
對 BT9G 一類索引系統而言,最重要的不是單純追求事件數量,而是把內容身份、網路觀察、採集狀態和搜索文檔拆成清晰的資料層。所有來自 DHT 或 Peer 的欄位都應該保留來源與時間戳,並通過階段化指標區分發現、連接、協商、Metadata 獲取、校驗、入庫和索引等環節。這樣才能在規模擴大後定位真實瓶頸,而不是把所有失敗都歸因於“網路不穩定”。
常見誤區
- 把 routing table 當成全網節點資料庫。
- 看到新節點就無條件淘汰穩定舊節點。
- 長期不 refresh 冷門 bucket。
- 持久化聯繫人後在下次啓動中完全不做重新驗證。
相關 BT9G Labs 文章
- InfoHash 深度解析:BitTorrent v1、v2、Magnet、BTIH 與 BTMH
- BEP 5 DHT 報文詳解:ping、find_node、get_peers 與 announce_peer
- 為甚麼 DHT 會看到海量 InfoHash?理解互聯網規模的 Swarm 發現
- DHT Crawler 如何發現 InfoHash:主動查詢、網路觀察與負責任設計
參考資料
下一篇: 為甚麼 DHT 會看到海量 InfoHash?理解互聯網規模的 Swarm 發現 →
本文用於解釋公開的 BitTorrent 協議與工程實現思路,不代表任何被觀察到的 Swarm 一定可用、有效或被授權傳播。