
BT9G LABS / DHT 深度解析 #07
为什么 DHT 会看到海量 InfoHash?理解互联网规模的 Swarm 发现
解释 DHT 观察者为什么会持续看到大量 InfoHash,其中同时包含活跃、重复、陈旧和低质量信号。
BT9G Labs / DHT Deep Dive #07. 理解海量 InfoHash 流量从哪里来,以及为什么“观察到很多哈希”与“拥有很多有效 Metadata”完全是两回事。
快速摘要
- 主题: 为什么 DHT 会看到海量 InfoHash?理解互联网规模的 Swarm 发现
- 核心关键词: DHT InfoHash, Swarm 发现, BitTorrent 活动, 去重, DHT crawler
- 适合读者: 后端工程师、协议研究者、搜索工程师以及 BitTorrent 实现者
- 目标: 用足够准确的协议与系统视角解释原理,并能直接支持真实的采集、索引和搜索架构设计。
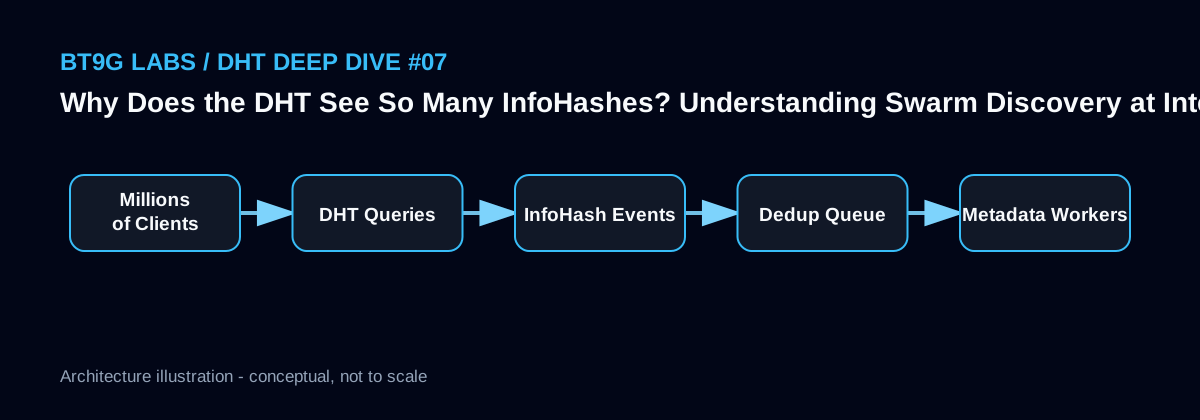
系统视图
InfoHash 来自活动,而不是中央注册表
DHT 中不存在一个可以下载的“全球 Torrent 目录”。InfoHash 会随着 Peer 查询、announce、节点路由和各种网络活动不断出现在观察视野中。不同位置、不同时间运行的节点看到的集合也不会完全相同。
因此所谓“每天发现多少新 InfoHash”本质上依赖观察点数量、在线时间、网络位置、查询策略和去重窗口。把任何单一 crawler 的计数直接称为“全网新增量”都需要谨慎。
为什么流里有大量噪声
观察到的哈希可能对应已经没有活跃 Peer 的旧资源,也可能是重复出现的热门内容、错误客户端产生的异常值、恶意噪声,甚至永远无法获得 Metadata 的标识。高事件速率并不自动等于高质量内容增长。
生产系统需要把 discovery event、unique InfoHash、active hash、metadata-success hash 分成不同指标。否则一个看起来非常漂亮的“每秒数千条”图表可能只是在重复统计相同信号。
去重决定采集成本
同一个热门 InfoHash 可能在一天内被观察上千次。如果每次事件都触发 Metadata 获取,连接数、CPU、带宽和失败重试都会被重复工作吞噬。合理的热路径会先用内存集合、Bloom filter 或 Redis 等手段快速判断是否近期处理过,再到持久层确认状态。
去重并不意味着丢弃活动信息。可以把内容身份只保存一次,同时累计 last_seen、observation_count、recent_activity 等独立信号,用于调度和排序。
活跃度是信号,不是绝对热门度
某个哈希在 DHT 中频繁出现,通常能说明近期网络活动较多,但不能简单转换成“全球用户数”或“精确下载量”。不同网络路径和采样策略会产生偏差,NAT 后多个客户端也可能表现为复杂的端点行为。
对搜索排序而言,更适合把 DHT 活跃度和最近成功获取 Metadata、Tracker scrape、Peer 可连接率等多个信号组合,而不是依赖单一计数。
实现示意
INSERT INTO infohash_observation(infohash, first_seen, last_seen, seen_count)
VALUES (?, NOW(), NOW(), 1)
ON DUPLICATE KEY UPDATE
  last_seen = VALUES(last_seen),
  seen_count = seen_count + 1;
BT9G Labs 工程笔记
对 BT9G 一类索引系统而言,最重要的不是单纯追求事件数量,而是把内容身份、网络观察、采集状态和搜索文档拆成清晰的数据层。所有来自 DHT 或 Peer 的字段都应该保留来源与时间戳,并通过阶段化指标区分发现、连接、协商、Metadata 获取、校验、入库和索引等环节。这样才能在规模扩大后定位真实瓶颈,而不是把所有失败都归因于“网络不稳定”。
常见误区
- 把单个 crawler 看到的数量称为全网精确新增量。
- 把 observation event 和 unique InfoHash 混为一谈。
- 每次重复看到哈希都重新抓 Metadata。
- 把 DHT 活跃次数直接解释为精确下载人数。
相关 BT9G Labs 文章
- BEP 5 DHT 报文详解:ping、find_node、get_peers 与 announce_peer
- DHT Routing Table 内部原理:k-Bucket、节点 Churn 与联系人选择
- DHT Crawler 如何发现 InfoHash:主动查询、网络观察与负责任设计
- Magnet 链接如何变成文件 Metadata:完整 Peer 与 Metadata 流程
参考资料
下一篇: DHT Crawler 如何发现 InfoHash:主动查询、网络观察与负责任设计 →
本文用于解释公开的 BitTorrent 协议与工程实现思路,不代表任何被观察到的 Swarm 一定可用、有效或被授权传播。